上一篇〈開放權重模型是什麼?〉提到,開放權重模型的一大好處是可以客製:用公司自己的資料再訓練,讓模型更懂你的產業。
這也引出客戶接下來最常問的問題:
- 「要怎麼把公司的資料『教』給模型?」
- 「聽說要買很多 GPU、花好幾個月?」
- 「我們的產品手冊、客服紀錄,丟進去訓練就好了嗎?」
先說結論:
微調(fine-tuning)最適合教模型「怎麼回答」:專業用語、語氣與判斷方式;經常變動、需要附上來源的公司資訊,則優先交給 RAG(讓 AI 先查資料再回答)。用 LoRA 這類方法,微調一個中小型模型的成本已經降到幾美元到幾百美元;真正的成本在準備好資料、評估效果,以及每次模型改版後的重新訓練。
這篇是「AI 模型種類」系列的第三篇。
本文資料查核截至 2026 年 10 月 8 日。參數規模以 B(十億)、T(兆)表示,例如 8B=80 億。
1. 先確認:你需要的真的是微調嗎?
很多「想訓練自己的 AI」的需求,其實用更簡單的方法就能解決。業界普遍建議的順序是:先調整提示詞 → 再接 RAG → 真的不夠才微調。(「權重」是什麼,可以參考上一篇的〈「權重」到底是什麼?〉。)
| 方法 | 做什麼 | 適合解決 | 成本與門檻 |
|---|---|---|---|
| 提示詞(prompt) | 在指令裡寫清楚規則、範例與格式 | 回答方向不對、格式不一致這類簡單問題 | 最低,改文字就好 |
| 結構化輸出(structured output) | 在模型產生回答時,直接限制只能輸出指定的欄位與選項 | 欄位缺漏、JSON 格式錯誤、類別選項寫法不一 | 低到中等,多數模型服務與推論工具都有支援 |
| RAG(檢索增強生成) | 讓模型回答前先查公司的文件 | 要回答產品規格、內部規章、最新資訊這類「事實」 | 中等,要建知識庫與檢索系統 |
| 微調(fine-tuning) | 用範例資料調整模型的權重 | 專業術語、語氣與判斷方式,前面的方法都做不好時 | 較高,要準備訓練資料、GPU 與評估 |
為什麼經常變動的公司資訊,不建議只靠微調?
- 知識會過期:產品規格一改,就得重新訓練;RAG 只要更新文件。
- 無法查證:微調後的模型說錯了,你不知道它是從哪裡學來的;RAG 可以附上引用的文件。
- 效果與副作用:研究發現,在測試的知識類任務上,RAG 的表現通常比微調好;微調也可能讓模型原本的能力退步(第 7 節會說明)。再訓練不是不能補強知識(第 3 節的繼續預訓練就是在做這件事),只是對經常變動的資訊,RAG 更好維護。
我們在〈導入 RAG 知識庫前,先確認這 5 件事〉與〈RAG 已死?〉兩篇中有更多說明。實務上最常見的組合是「RAG 負責知識、微調負責行為」:先用 RAG 讓模型查得到正確資料,再用微調讓它用公司要的格式與語氣回答。
2. 模型是怎麼訓練出來的?
要理解「再訓練」能做什麼,先看一個模型從無到有的過程。為了方便理解,本文把它簡化成三個階段;實際上不同模型的訓練流程不盡相同:
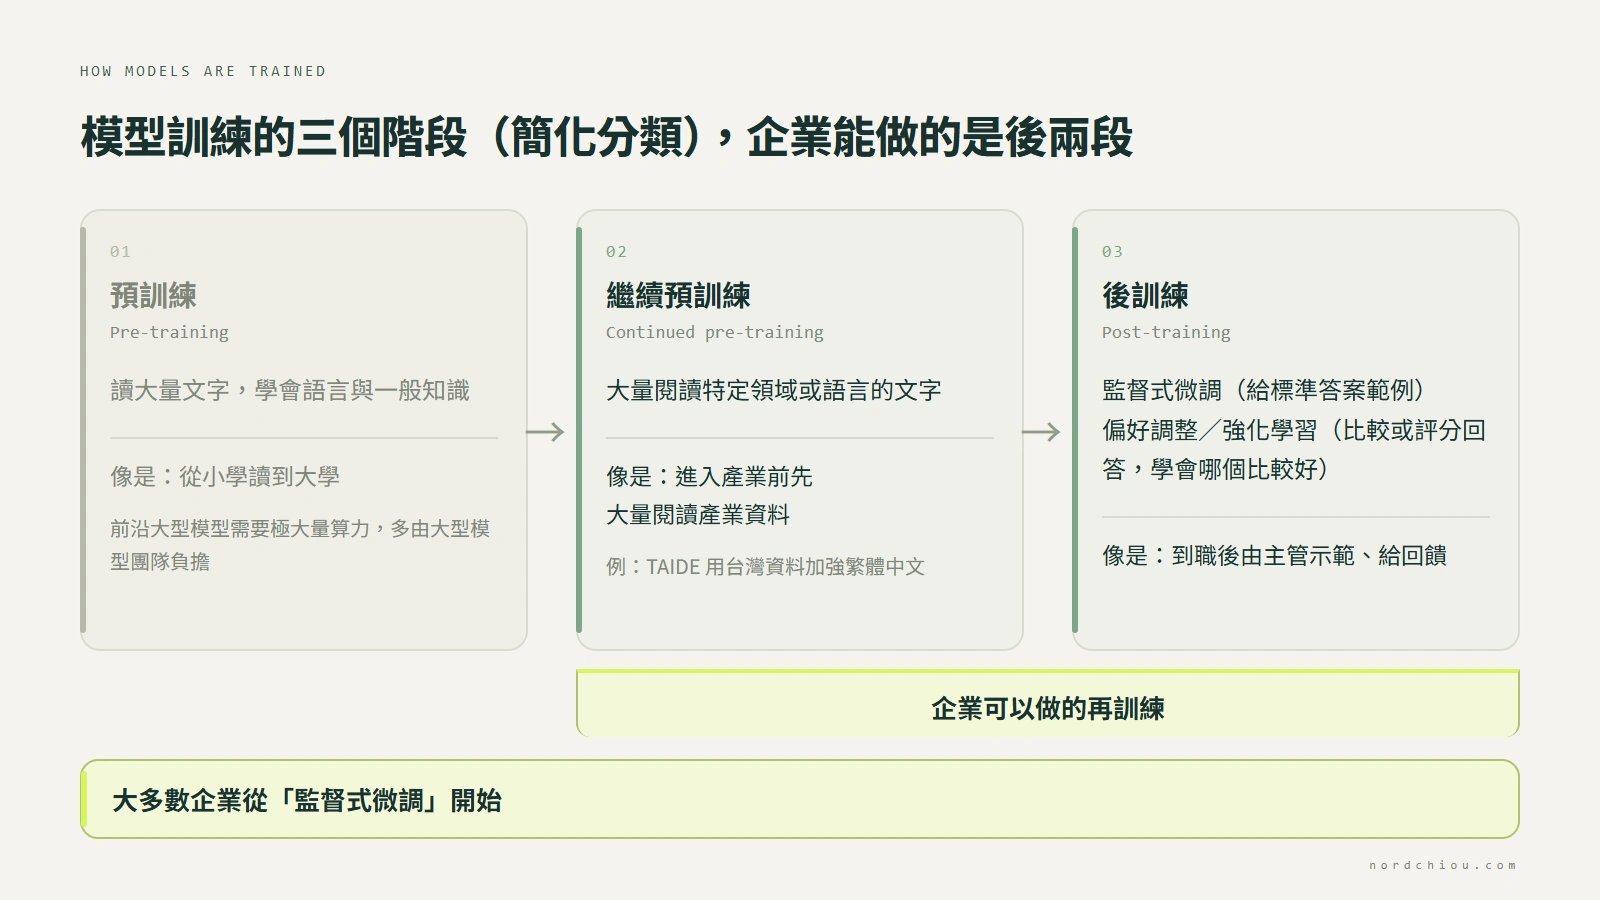
用培養一位新員工來比喻:
| 階段 | 做什麼 | 像是 | 誰做得起 |
|---|---|---|---|
| 1. 預訓練(pre-training) | 讀大量的文字,學會語言與一般知識 | 從小學讀到大學,打下基本功 | 前沿大型模型需要極大量的資料與算力,多由大型模型團隊負擔;一般企業直接使用既有模型 |
| 2. 繼續預訓練(continued pre-training) | 再讀大量特定領域或語言的文字 | 進入某個產業前,先大量閱讀產業資料 | 有大量領域文本、預算較充足的機構 |
| 3. 後訓練(post-training) | 用範例與回饋,教模型怎麼對話、遵守指示 | 到職後由主管示範、給回饋,學會公司的做事方法 | 大多數企業可以做的就是這一段 |
我們下載的開放權重模型,名稱裡帶有 Instruct 或 Chat 的,通常已經做過後訓練、可以直接對話。企業的再訓練,就是在這個基礎上「再加工」。
3. 企業能做的四種再訓練方式
| 方式 | 教模型什麼 | 需要的資料 | 適合的情境 |
|---|---|---|---|
| 監督式微調(Supervised Fine-Tuning,SFT) | 照著標準答案學:看到這種問題,就這樣回答 | 「問題+理想答案」的範例,通常數百到數千筆 | 固定報告格式、客服回覆風格、從文件擷取欄位 |
| 偏好調整(如 DPO,直接偏好最佳化) | 比較兩個回答,學會哪個比較好 | 「同一題的好答案+差答案」配對,數量依任務與資料品質而定 | 語氣拿捏、避免囉嗦、該拒絕時要拒絕 |
| 強化學習微調(Reinforcement Fine-Tuning) | 自己多試幾種答法,由評分規則打分數,往高分的方向調整 | 題目+評分方式(可以是自動規則,例如答案對不對、格式是否正確,也可以由另一個 AI 評分) | 最適合有明確對錯標準的任務:計算、分類、程式、規則判斷 |
| 繼續預訓練 | 大量閱讀某個領域或語言的文字,補強底層知識 | 大量領域文本,通常遠多於監督式微調需要的資料 | 專業領域用語極多、或要強化特定語言(例如繁體中文) |
幾個實際的例子:
- 繼續預訓練:國科會的 Gemma-3-TAIDE-12b-Chat-2602,就是以 Google 的 Gemma 3 為基礎,用台灣的資料做持續預訓練與中期訓練,再加上監督式微調,加強繁體中文、台灣文化與用語,並修正翻譯腔。
- 強化學習:據小米公布,MiMo-V2.6-Pro 的一次大規模強化學習階段,在不到六天內產生約 75 萬條 Agent(會自行執行多步驟工作的 AI)任務執行紀錄,該階段的成本約 262 萬美元。這是模型廠商的規模,但同樣的方法,企業也能用在小得多的範圍。
- 監督式微調:一家公司想讓模型把客服對話整理成固定格式的工單,準備幾百到一千筆「對話+正確工單」的範例,就是典型的 SFT。
對大多數企業來說,起點幾乎都是監督式微調:資料最好準備、效果最好評估。偏好調整與強化學習,通常是在 SFT 之後、還想再進一步時才加上。
還有一種:蒸餾
蒸餾(distillation)是讓大模型當老師、小模型當學生。常見的做法之一,是先用大模型產生大量高品質的回答,再拿這些回答去微調小模型。這樣就能用便宜、快速的小模型,處理原本需要大模型才做得好的特定任務。
要注意的是,許多閉源模型的使用條款禁止用它的輸出來訓練競爭模型,用哪個模型當老師之前,請先確認條款。
4. LoRA:為什麼微調變便宜了?
傳統的微調要調整模型的全部參數(全參數微調,full fine-tuning)。一個 70B 的模型就有 700 億個參數要更新,需要多張高階 GPU、跑好幾天。
LoRA(Low-Rank Adaptation,低秩適應)換了一個做法:原本的權重完全不動,只在旁邊加上一組很小的「外掛」參數來訓練。
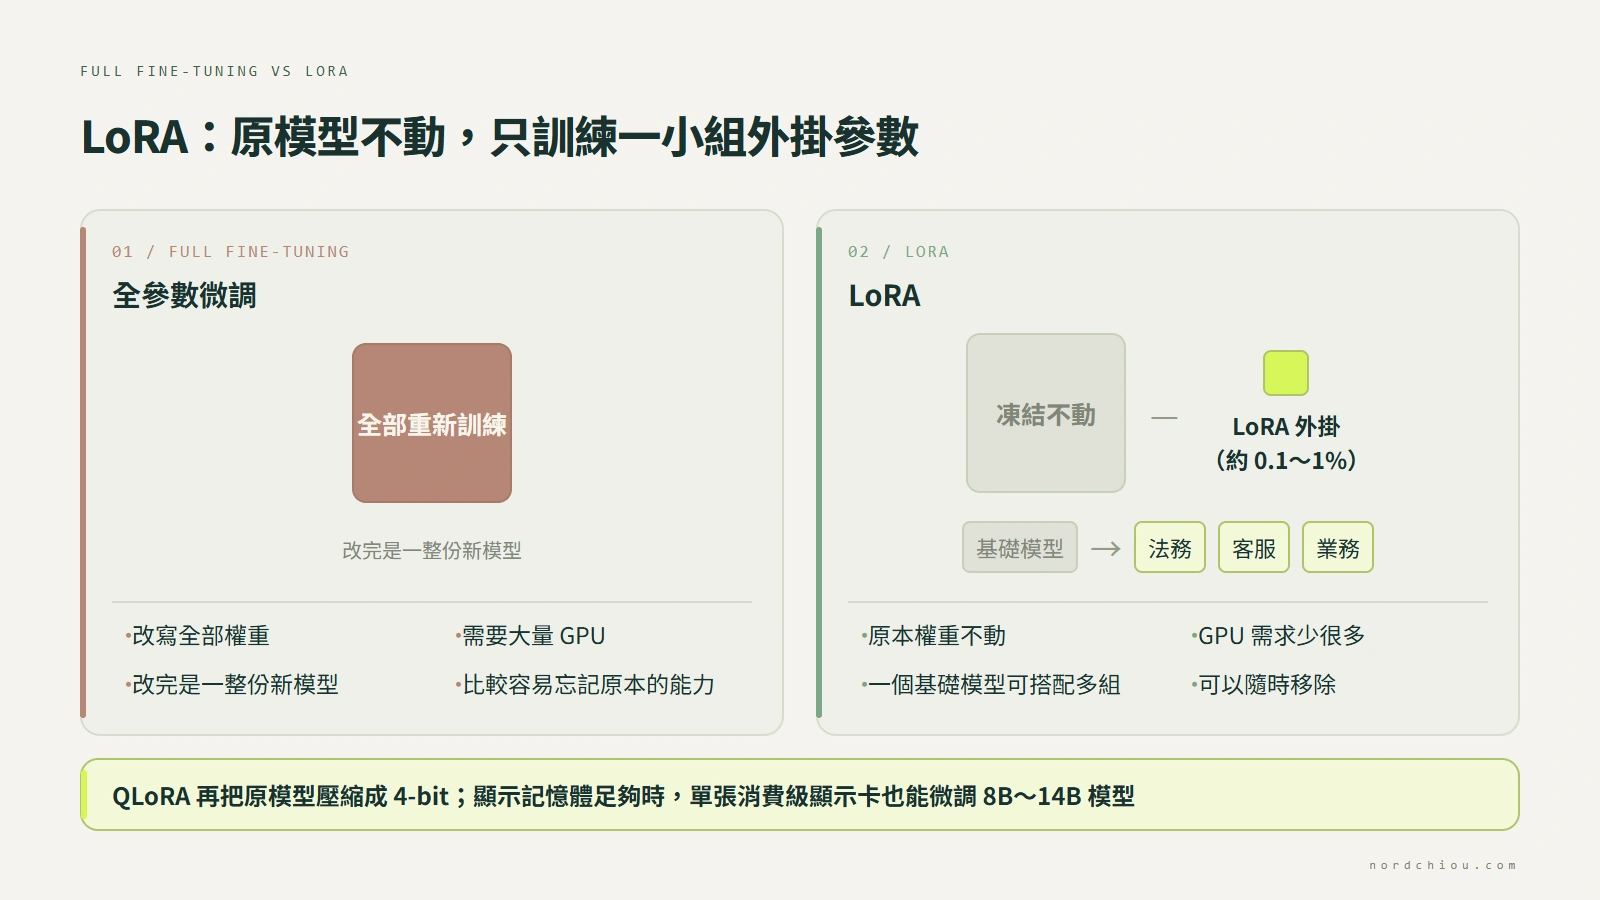
用一本厚厚的操作手冊來比喻:
- 全參數微調像把整本手冊重新改寫一遍,工程浩大,改完就是另一本手冊(原本的版本要另外保存好)。
- LoRA 像在手冊上貼便利貼:原文一字不改,只在需要的地方補充說明。便利貼可以隨時撕掉,也可以為不同部門準備不同的一組。
| 方法 | 訓練多少參數 | 優點 | 代價 |
|---|---|---|---|
| 全參數微調 | 全部 | 可以調整的範圍最大 | 需要大量 GPU;較容易讓模型忘記原本的能力;每個版本都是一整份模型 |
| LoRA | 通常只有總數的 0.1~1% | 需要的 GPU 少很多;原模型不變;一個基礎模型可以搭配多組 LoRA | 在許多任務上能接近全參數微調,但效果取決於任務、資料與設定 |
| QLoRA | 同 LoRA,但先把原模型壓縮成 4-bit | 原模型佔用的記憶體大幅降低,記憶體足夠的消費級顯示卡也能訓練中型模型 | 整體記憶體需求與效果仍須實測 |
「一個基礎模型搭配多組 LoRA」在企業裡特別實用:法務部、客服部、業務部可以各自有一組 LoRA,共用同一個基礎模型,切換時只要換掉那一小組參數。
「壓縮成 4-bit」是什麼意思?
模型的權重是幾十億個數字。這些數字平常用 16-bit 儲存,也就是每個數字用 16 個 0 或 1 來記錄,有 65,536 種組合可以用。4-bit 則只用 4 個 0 或 1,只有 16 種組合,但佔用的空間只有四分之一。這種「用比較少的位元記錄數字」的技術,就叫做量化(quantization)。
用量尺來比喻:16-bit 像一把刻度很密的尺,可以量到很細;4-bit 像一把只有 16 個刻度的尺,量出來比較粗,但尺本身小很多。(這是簡化的比喻,實際的刻度不一定平均分布,下面會說明。)
那麼只有 16 個刻度,怎麼還能保持準確?做法大致是:
| 步驟 | 做什麼 |
|---|---|
| 1. 分組 | 把權重切成很多小組,例如每 64 個數字一組 |
| 2. 各組自訂比例 | 每組先記下自己的數值範圍(一個「縮放比例」),再把組內每個數字,對應到 16 個刻度中最接近的一個,只記下刻度編號 |
| 3. 計算時還原 | 要用到時,先依刻度編號查出它代表的值,再乘上該組的縮放比例,還原成近似值,拿去計算 |
因為每一小組都有自己的刻度範圍,誤差可以控制得很小。QLoRA 還多了兩個巧思:
- 刻度不平均分配:模型的權重大多集中在 0 附近,所以 QLoRA 使用的 NF4 格式把刻度在 0 附近排得比較密、兩端比較疏,用同樣的 16 格就能更準確。
- 只壓縮不動的部分:被壓縮的是凍結不動的原模型;真正要訓練的 LoRA 外掛,仍然用較高的精度計算(常用 BF16 這種 16-bit 格式)。
以一個 8B 模型為例,用 16-bit 存放權重約需 16GB,壓縮成 4-bit 後只要 4GB 多。這就是為什麼 QLoRA 能讓記憶體有限的顯示卡也訓練得動中型模型;QLoRA 論文的實驗中,效果可以接近 16-bit 微調,但實際表現仍要用自己的任務測試。
上一篇提到的「以壓縮格式執行模型」,用的也是同樣的量化技術,只是那裡是為了執行模型,這裡是為了訓練。
需要多少硬體?
以 Unsloth(熱門的開源微調工具)公布的最低需求為例:
| 模型規模 | QLoRA(4-bit) | LoRA(16-bit) |
|---|---|---|
| 8B | 約 6GB | 約 22GB |
| 14B | 約 8.5GB | 約 33GB |
| 32B | 約 26GB | 約 76GB |
| 70B | 約 41GB | 約 164GB |
單位為 GPU 顯示記憶體;這是最低需求,不是採購建議,實際會因模型架構、訓練資料長度與設定而增加,請預留餘裕。
換句話說,在顯示記憶體足夠、設定適當的情況下,8B 到 14B 的模型用一張消費級顯示卡就能做 QLoRA 微調;上一篇提到的上兆參數大型模型,則需要多張資料中心級 GPU,大多數企業不會從那裡開始。
成本方面,以 GPU 雲端平台 Spheron 在 2026 年 9 月公布的價格為例,H100(80GB)每小時約 2.6 美元。依該平台的試算範例,用 QLoRA 微調 7B 模型約需數小時、數美元;70B 模型約半天、數十美元;70B 全參數微調用 8 張 H100 跑一到兩天,約數百到上千美元。這些只是 GPU 租用費,實際時間還會隨資料量、文本長度與訓練輪數而變。GPU 費用通常不是最大的成本,準備資料與評估才是。
5. 資料準備:品質比數量重要
訓練資料的品質,是影響微調效果最重要的因素之一。幾個原則:
| 原則 | 說明 |
|---|---|
| 品質優先 | 1,000 筆仔細整理的範例,效果常勝過 5 萬筆品質參差的資料。模型會連錯誤與壞習慣一起學起來 |
| 範例要像真實使用 | 用實際會遇到的問題與理想答案,而不是憑空想像的題目 |
| 涵蓋困難與例外 | 不只放標準情況,也要放模型容易答錯、應該拒絕或轉人工的情境 |
| 保留一份考題 | 先切出一成左右的資料不拿來訓練,專門用來檢查微調後的效果 |
| 清除個資與機密 | 模型可能把訓練資料原封不動地「背」出來,客戶個資、密碼、合約細節要先去識別化 |
資料從哪裡來?常見的來源是過去的客服紀錄、人工撰寫的報告、專家審過的案例。資料不夠時,也可以先用大模型產生範例,再由人工審核修正(要留意前面提到的使用條款)。
6. 工具與平台:自己做還是交給雲端
| 方式 | 代表工具或服務 | 適合 |
|---|---|---|
| 圖形介面工具 | Unsloth Studio、LLaMA-Factory | 想先在自己的電腦或單台伺服器上試做、不想寫程式的團隊。兩者都提供網頁介面,選模型、上傳資料、按下訓練即可 |
| 程式框架 | Hugging Face TRL、Axolotl | 有工程團隊、要做多 GPU 訓練或偏好調整、強化學習等進階方法 |
| 雲端代管微調 | AWS Bedrock、Google Cloud、Azure 等平台的微調服務 | 不想自己管 GPU,或資料本來就在雲端上的企業 |
以 AWS Bedrock 為例,2026 年 2 月起支援對 gpt-oss-20B、Qwen3 32B 等開放權重模型做強化學習微調:上傳題目、設定評分規則,訓練完成後就能直接透過 API 使用。各平台支援的模型與地區差異很大,選用前請先確認。
自己做還是交給雲端? 原則和上一篇一樣:資料不能離開公司就自己做,否則雲端代管通常更省事。
實例:把客服對話整理成固定格式的工單
用一個實際的例子,走一遍用圖形介面工具微調的過程。
情境:客服人員每天要把幾百通對話整理成工單,欄位包括類別、產品、問題摘要、是否要轉維修。直接請模型整理,常常欄位不齊、用語不一致。
這裡要先說一個重點:如果問題只是欄位缺漏或格式錯誤,應該先試「結構化輸出」,在生成時就限制模型只能輸出指定的欄位與類別選項,通常不需要微調。這個例子之所以進一步做微調,是因為格式固定之後,類別該怎麼歸、要不要轉維修這類判斷仍然不穩定,需要用公司的實際案例教模型怎麼判斷。實務上,兩者經常一起使用。
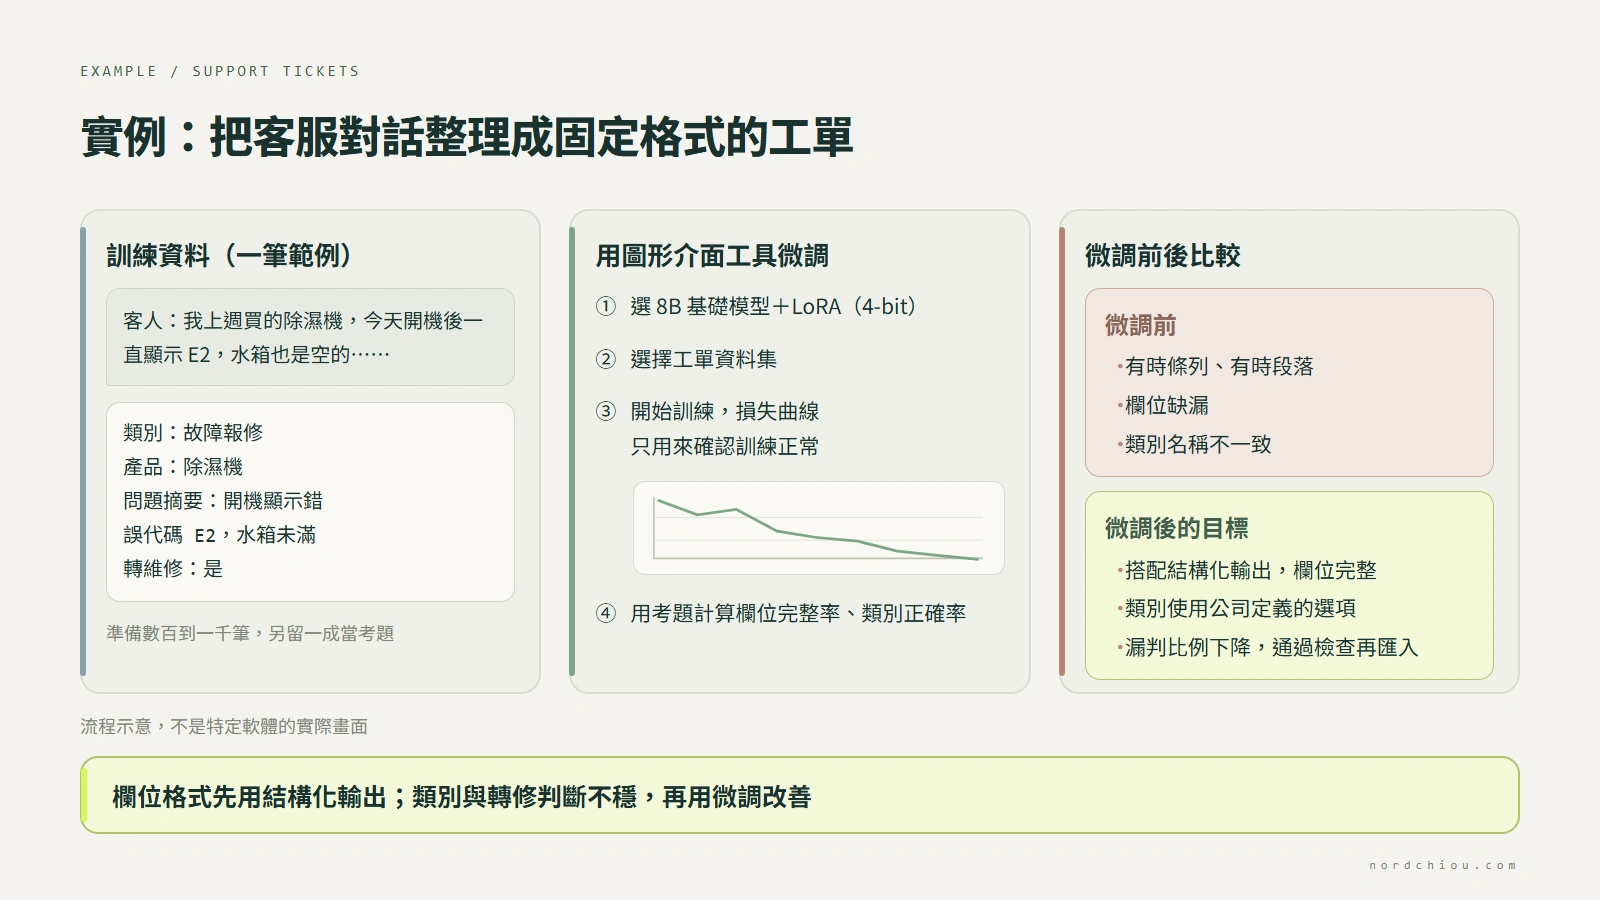
上圖為流程示意,不是特定軟體的實際畫面。
第一步:準備訓練資料。 每一筆資料都是「一段對話+整理好的標準工單」,通常存成一行一筆的 JSON 格式(JSONL)。一筆資料大致長這樣:
{"messages": [
  {"role": "system",
   "content": "你是客服工單整理助理,請把對話整理成固定欄位的工單。"},
  {"role": "user",
   "content": "客人:我上週買的除濕機,今天開機後一直顯示 E2……"},
  {"role": "assistant",
   "content": "{\"類別\": \"故障報修\", \"產品\": \"除濕機\", \"轉維修\": true}"}
]}
實際檔案中,一筆資料會寫在同一行;這裡為了方便閱讀分行顯示,工單欄位也只節錄一部分。
這樣的資料準備數百到一千筆,並另外保留一成當考題。
第二步:在工具裡設定與訓練。 以 LLaMA-Factory 的網頁介面為例,安裝後執行 llamafactory-cli webui 就會開啟操作頁面。頁面上方是共用設定區(選模型、微調方法、量化等),下方分成「訓練」(Train)、「評估與預測」(Evaluate & Predict)、「對話」(Chat)、「匯出」(Export)四個分頁(中文名稱為本文翻譯):
| 步驟 | 在哪裡操作 | 設定什麼 |
|---|---|---|
| 1. 選模型 | 上方共用設定區 | 選一個 8B 左右的開放權重模型作為基礎 |
| 2. 選方法 | 上方共用設定區 | 微調方法選 LoRA;顯示卡記憶體不夠時,量化選 4-bit(也就是 QLoRA) |
| 3. 選資料與階段 | 訓練分頁 | 訓練階段選監督式微調(SFT),再選擇剛才準備、並在工具裡登記好的工單資料集 |
| 4. 開始訓練 | 訓練分頁 | 先用預設的學習率與訓練輪數,按下開始,畫面會顯示訓練進度與損失曲線(模型在訓練資料上的誤差變化,只用來確認訓練是否正常) |
| 5. 測試 | 對話分頁 | 載入訓練好的 LoRA,貼幾段沒看過的客服對話,看輸出是否符合需求 |
| 6. 產生考題答案 | 評估與預測分頁 | 讓模型回答保留的考題,輸出結果用來計算業務指標(見第三步) |
| 7. 匯出 | 匯出分頁 | 確認有效後,把模型或 LoRA 存成正式系統可以載入的檔案 |
用一張消費級顯示卡做 QLoRA,這樣規模的資料通常幾十分鐘到幾個小時就能訓練完。
第三步:比較微調前後。 損失曲線下降,只代表模型越來越貼近訓練資料,不代表在沒看過的案件上表現更好。所以要用沒參與訓練的考題,自己計算業務指標,例如欄位完整率、類別正確率、該轉維修卻漏判的比例。重點看三件事:
| 檢查項目 | 微調前常見的問題 | 微調後應該做到 |
|---|---|---|
| 格式 | 有時輸出條列、有時輸出段落,欄位缺漏 | 搭配結構化輸出,欄位完整;通過檢查後再匯入系統 |
| 用語 | 同一類問題,類別名稱寫法不一 | 類別名稱固定使用公司定義的選項 |
| 判斷 | 該轉維修的案件漏判 | 依範例學到的規則判斷,漏判比例明顯下降 |
如果指標沒有明顯進步,先檢查資料(範例太少、品質不一、例外情況沒涵蓋),再檢查基礎模型、資料格式與訓練設定。多數時候,回頭修資料會比調整訓練參數更有效。
7. 微調的四個常見風險
| 風險 | 發生什麼事 | 怎麼降低 |
|---|---|---|
| 忘記原本會的事 | 也稱為「災難性遺忘」(catastrophic forgetting):模型在新任務上變強,卻在其他能力上退步,例如一般問答、寫作品質變差 | 優先用 LoRA;訓練資料裡混入一些一般範例;微調前後都跑同一套測試比較 |
| 安全防護被削弱 | 研究發現,即使用完全正常的資料微調,也可能讓模型原本的安全限制變弱,更容易產生不當內容 | 微調後重新做安全測試;對外服務另外加上內容過濾 |
| 模型改版就要重來 | 基礎模型每幾個月就更新;換了基礎模型後,原本的 LoRA 不能假設仍然適用,須重新驗證,通常需要重新訓練 | 把資料、訓練設定與評估方式保存好,讓重新訓練變成例行流程 |
| 授權條件延續到衍生模型 | 微調後的模型仍受原授權約束。以 Kimi K3 為例,以模型對外提供服務、營收達一定規模者須另外簽約,大型商業產品須標示模型名稱,這些條件同樣適用於衍生模型;但內部使用等情況另有豁免,要依實際使用方式確認 | 選基礎模型時就先確認授權;Apache 2.0、MIT 等寬鬆授權最單純 |
8. 企業導入微調的步驟
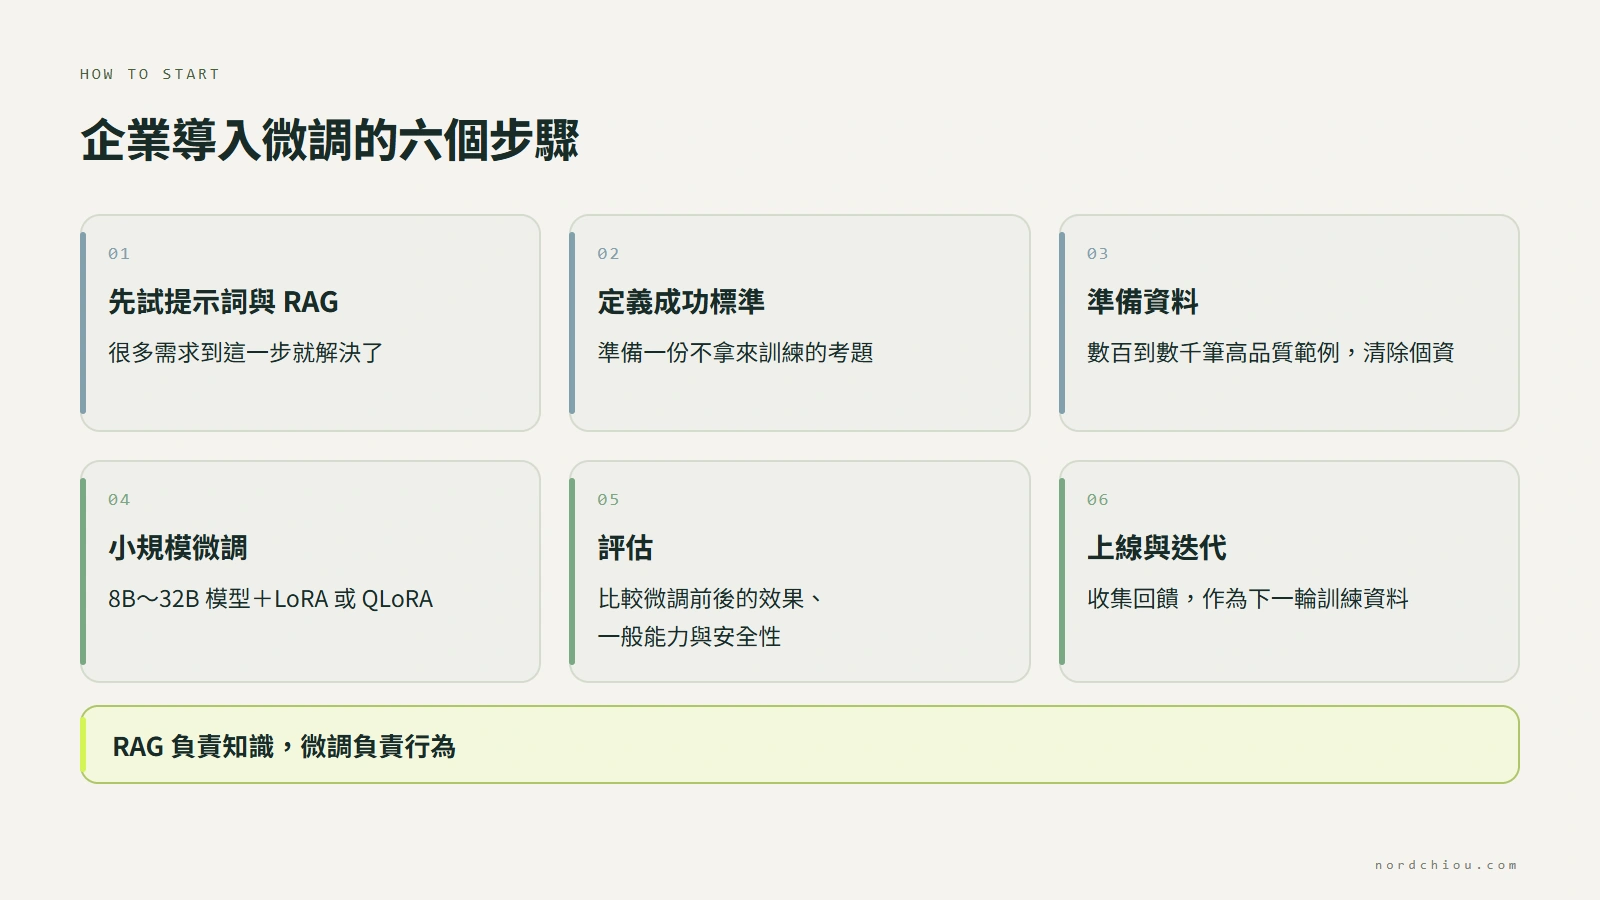
| 步驟 | 做什麼 | 重點 |
|---|---|---|
| 1. 先試簡單的方法 | 用提示詞與 RAG 做到最好 | 很多需求到這一步就解決了 |
| 2. 定義成功標準 | 寫清楚「什麼樣的輸出算合格」,準備一份不拿來訓練的考題 | 沒有考題,就無法判斷微調有沒有用 |
| 3. 準備資料 | 數百到數千筆高品質範例,清除個資與機密 | 這是最花時間、也最影響結果的一步 |
| 4. 小規模微調 | 選 8B~32B 的開放權重模型,用 LoRA 或 QLoRA 訓練 | 先用小模型驗證方向,不要一開始就挑戰最大的模型 |
| 5. 評估 | 用考題比較微調前後,同時檢查一般能力與安全性 | 有進步才繼續,沒進步就回頭檢查資料 |
| 6. 上線與迭代 | 小範圍上線,收集使用者回饋 | 回饋與修正後的答案,就是下一輪的訓練資料 |
結語:微調是「最後一哩路」,不是第一步
開放權重模型加上 LoRA,讓微調從「大公司才做得起」變成一般企業也負擔得起的工具。但它最擅長的是特定問題:讓模型用你要的方式回答與判斷。經常變動、需要附上來源的公司資訊,仍然優先交給 RAG;格式問題,先試結構化輸出。真的要微調時,從小模型、小資料、LoRA 開始,用考題證明有效後再擴大。
如果你正在評估公司的需求適不適合微調,或已經有資料想試試看,可以從導入診斷開始:我們會先檢視你的使用情境與既有資料,判斷該從提示詞、RAG 還是微調著手,並規劃資料準備與評估方式。
參考資料
- Hu 等,〈LoRA: Low-Rank Adaptation of Large Language Models〉,arXiv,2021
- Dettmers 等,〈QLoRA: Efficient Finetuning of Quantized LLMs〉,arXiv,2023
- Rafailov 等,〈Direct Preference Optimization: Your Language Model is Secretly a Reward Model〉,arXiv,2023
- Ovadia 等,〈Fine-Tuning or Retrieval? Comparing Knowledge Injection in LLMs〉,arXiv,2023
- Qi 等,〈Fine-tuning Aligned Language Models Compromises Safety, Even When Users Do Not Intend To!〉,arXiv,2023
- Unsloth,〈Unsloth Requirements〉
- LLaMA-Factory,〈WebUI 說明文件〉
- AWS,〈Fine-tune open-weight models using OpenAI-compatible APIs〉
- AWS,〈Amazon Bedrock reinforcement fine-tuning adds support for open-weight models with OpenAI-compatible APIs〉,2026
- Hugging Face,〈Structured Generation〉
- 小米,〈MiMo-V2.6 官方公告〉,2026
- Spheron,〈How to Fine-Tune LLMs in 2026: Costs, GPUs, and Code〉,2026
- VentureBeat,〈Xiaomi's MiMo-V2.6-Pro debuts as the top open weights model in the world〉,2026
- TAIDE,〈Gemma-3-TAIDE-12b-Chat-2602 模型卡〉
- Moonshot AI,〈Kimi K3 License〉,2026