九月是 AI 圈特別熱鬧的一個月。短短四週內,四家公司相繼推出新模型,而且每一家都宣稱自己是「目前最強」:
| 日期 | 公司 | 推出的模型 |
|---|---|---|
| 9 月 3 日 | OpenAI | GPT-6 Astra |
| 9 月 21 日 | xAI | Grok 4.7 |
| 9 月 22 日 | Anthropic | Claude Opus 5.5 |
| 9 月 22 日 | OpenAI | GPT-6 Sol、GPT-6 Luna |
| 9 月 28 日 | Anthropic | Claude Sonnet 5.5 |
| 9 月 29 日 | OpenAI | GPT-6.1 Sol |
| 9 月 30 日 | Gemini 4 Argon |
客戶最常問我們的是:「Claude、ChatGPT、Gemini 到底哪個比較好?我們公司該選哪一個?」
先說結論:
前沿模型之間的能力差距,已經小到每幾個月就換一次冠軍。企業真正該比較的不是「誰最強」,而是「哪個生態系最貼近你的工作、資料能不能安心交出去、用哪一級的模型就夠」,並且保留隨時換模型的彈性。
這篇是「AI 模型種類」系列的第一篇,先從最受關注的前沿模型開始:以 Claude、GPT、Gemini、Grok 四大家族為主,也會順帶介紹 9 月推出 Muse Spark 1.3 的 Meta,以及正在追上的開放權重模型;這些模型的細節,以及小型模型與特定用途的模型,會在後續文章分別介紹。
本文資訊截至 2026 年 10 月 7 日。模型更新非常快,數字與名稱請以各家官方公告為準。
1. 什麼是前沿模型?
前沿模型(frontier model)指的是在通用能力上最接近當前技術前沿的一群模型,通常是各大 AI 公司的頂級產品。它們通常有四個共同特徵:
| 特徵 | 說明 |
|---|---|
| 訓練成本極高 | 動輒需要數萬到十萬張以上的 GPU(繪圖處理器,AI 運算的主要晶片)。例如 GPT-6 Astra 就是用超過 10 萬張 GPU 訓練的,全世界只有少數公司負擔得起 |
| 閉源(closed-source) | 模型本身不公開,只能透過官方的聊天產品,或 API(應用程式介面,讓你的系統用程式呼叫模型)使用 |
| 能力最全面 | 寫作、分析、寫程式、看圖、操作電腦都能做,也是各種 AI Agent(會自己規劃步驟、使用工具把事情做完的 AI)背後的「大腦」 |
| 更新很快 | 各家大約每兩到四個月就推出新版本,排行榜第一名經常易主 |
用汽車來比喻:前沿模型就像各車廠的旗艦車款,代表這家公司的最高技術水準。但就像不是每個人都需要開旗艦車,企業日常大部分的工作,也不一定需要用到最頂級的模型(第 5 節會再說明)。
2. 模型和產品不一樣:ChatGPT 不是模型
討論之前,先釐清一個常見的混淆:你每天打開的 ChatGPT、Claude、Gemini,是「產品」;背後真正在思考的,是「模型」。
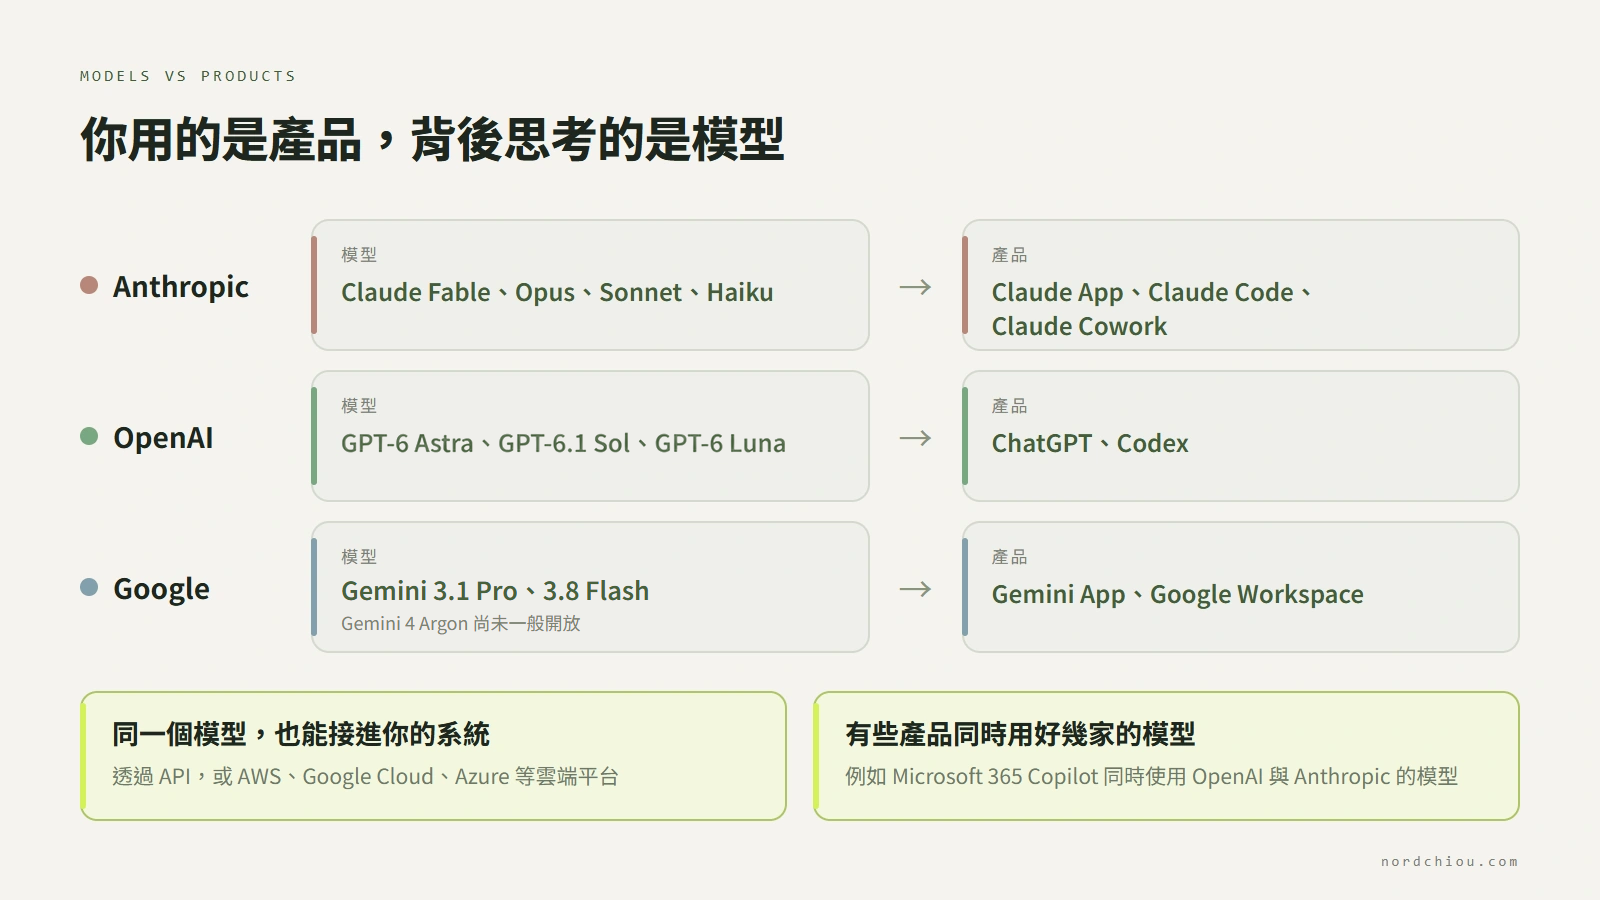
| 你用的產品 | 公司 | 背後的模型 |
|---|---|---|
| ChatGPT、Codex | OpenAI | GPT 系列(GPT-6 Astra、GPT-6.1 Sol 等) |
| Claude App、Claude Code、Claude Cowork | Anthropic | Claude 系列(Fable、Opus、Sonnet、Haiku) |
| Gemini App、Google Workspace | Gemini 系列(3.1 Pro、3.8 Flash 等;頂級的 4 Argon 尚未一般開放) | |
| Microsoft 365 Copilot | 微軟 | 同時使用 OpenAI 與 Anthropic 的模型 |
這個區分對企業很重要,原因有兩個:
- 同一個模型,可以從很多地方用到。 例如 Claude 的模型也能透過 AWS、Google Cloud、Microsoft Azure 使用。公司已經有雲端合約與資安審查的話,通常可以沿用既有的採購與帳務流程,但仍要確認模型的使用條款、權限、可用地區與啟用要求。
- 產品好不好用,不只取決於模型。 介面設計、能串接哪些工具、記憶與檔案管理方式都有影響。我們在 AI Agent 比較 一文中也提過:Agent 產品之間的差別,主要不在背後用哪個模型。
3. 四大家族的最新陣容(2026 年 10 月)
目前公認站在最前線的,主要是以下四家:
| 家族 | 公司 | 目前主力 | 一句話特色 |
|---|---|---|---|
| Claude | Anthropic | Fable 5.1、Opus 5.5 | 寫程式與長時間 Agent 任務表現突出,三大雲端都能用 |
| GPT | OpenAI | GPT-6 Astra、GPT-6.1 Sol | 使用者最多,主打操作電腦與專業工作 |
| Gemini | 3.1 Pro、3.8 Flash(頂級的 4 Argon 尚未一般開放) | 多模態與長文本見長,Google Workspace 整合最深 | |
| Grok | xAI | Grok 4.7 | 價格低,可搜尋 X 的即時內容 |
另外,Meta 在 9 月推出的 Muse Spark 1.3 實力也相當接近,放在本節最後介紹。以下各家都用同樣的格式整理:模型陣容 → 強項 → 要注意的地方。
Claude(Anthropic)
Claude 5 系列分成四個等級,產品定位由高到低是 Fable、Opus、Sonnet、Haiku:
| 等級 | 模型 | 推出 | 重點 |
|---|---|---|---|
| 最高級 | Fable 5.1 | 9 月 1 日 | 定位最高、價格最貴的 Claude,等級在 Opus 之上 |
| 旗艦 | Opus 5.5 | 9 月 22 日 | 大部分工作已達 Fable 水準,執行成本比 Opus 5 低約 40% |
| 中階 | Sonnet 5.5 | 9 月 28 日 | 比上一代 Sonnet 5 快 30% 以上,部分程式測試勝過 Opus 5.5 |
| 輕量 | Haiku 5.5 | 尚未推出 | 官方表示未來幾週推出;目前可用的是 Haiku 4.5 |
強項:
- 寫程式與長時間的 Agent 任務表現突出:在第三方綜合評測中,Opus 5.5 與 Sonnet 5.5 目前分居第一、二名(見第 4 節);Claude Code 與 Claude Cowork 都建立在這個能力之上。
- 通路最廣:同時上架 AWS、Google Cloud 和 Microsoft Azure,不論公司用哪一家雲端,大多能沿用既有的採購與資安流程(仍需另外啟用模型、確認條款)。
要注意:
- 等級最高,不等於分數最高:Fable 5.1 是 9 月初推出的 5.1 世代;9 月下旬推出的 5.5 世代(Opus 5.5、Sonnet 5.5)雖然等級較低,但在第三方綜合評測中已經反超 Fable 5.1(見第 4 節),價格還只有它的四成到五分之一。新專案建議直接以 5.5 世代為主力,不一定要用到 Fable。
- Fable 有一個同模型、但限制較寬鬆的版本 Claude Mythos 5.1,只透過 Anthropic 的受信任存取計畫(資安、生命科學)開放給經審核的個人與組織,目前僅限部分美國組織。一般版的 Fable 遇到滲透測試(模擬駭客攻擊來找系統弱點)、漏洞利用這類高風險請求,會自動轉給 Opus 處理。
GPT(OpenAI)
OpenAI 今年的節奏最快:3 月 GPT-5.4、4 月 GPT-5.5、7 月 GPT-5.6,9 月推出新一代 GPT-6。GPT-6 分成三個等級:
| 等級 | 模型 | 推出 | 重點 |
|---|---|---|---|
| 最高級 | GPT-6 Astra | 9 月 3 日 | 官方稱電腦操作、軟體工程、資安達頂尖水準 |
| 旗艦 | GPT-6.1 Sol | 9 月 29 日 | 表現「幾乎追平 Astra」,每 token 價格只有五分之一 |
| 輕量 | GPT-6 Luna | 9 月 22 日 | 最快、最便宜,適合大量、單純的任務 |
強項:
- GPT-6 Astra 能力全面:依 OpenAI 公布的評測,它在電腦操作、瀏覽器操作、軟體工程、資安與科學上都達到頂尖水準,總裁 Greg Brockman 形容這是「世代級的躍進」。
- 使用者基礎廣泛:ChatGPT 是最廣為人知的 AI 產品之一。如果員工已經習慣用 ChatGPT,導入時的教育成本通常比較低。
- Agent 產品完整:Codex 與 ChatGPT Work,讓 GPT 模型直接延伸到工作流程中。
要注意:
- GPT-6.1 Sol 在 ChatGPT 裡目前只出現在 Work 與 Codex(付費方案),一般對話介面還沒上線;要串接公司自己的系統,則可以直接透過 API 使用。
- 原本預計 10 月推出的 GPT-6.1 Astra 已取消:多家媒體轉述《華爾街日報》報導,原因是內部安全測試發現,它比前一版更容易沒有如實說明自己做了哪些動作。
- 上一代 GPT-5.6(分成 Sol、Terra、Luna 三級)仍可使用,但新專案建議直接評估 GPT-6:GPT-6 Sol 推出時,價格就比 GPT-5.6 Sol 降了一半。
Gemini(Google)
Google 的策略是「一個旗艦、很多台工作馬」:
| 等級 | 模型 | 推出 | 重點 |
|---|---|---|---|
| 最高級 | Gemini 4 Argon | 9 月 30 日 | 程式與資安大幅進步,能自動修補軟體漏洞 |
| 旗艦 | Gemini 3.1 Pro | 2 月 | 一般企業目前實際用得到的主力(API 仍標示為預覽版) |
| 中階 | Gemini 3.8 Flash | 9 月 2 日 | Google 的「工作馬」,快又便宜 |
| 輕量 | Gemini 3.5 Flash-Lite | 7 月 | 適合大量、即時性高的任務 |
強項:
- 資安能力突出:Google 表示 Gemini 4 Argon 特別針對資安防禦訓練,能自動找出、驗證並修補軟體漏洞;單次輸出上限也提高到 100 萬 token。
- 多模態(multimodal):同時看得懂文字、圖片、影片與聲音。
- 長文本:一次可讀入約 100 萬個 token,大約是好幾本書的份量。
- 整合最深:已內建在 Gmail、Google 文件、試算表與 Meet 裡,Gemini App 月活躍用戶超過 10 億。公司本來就用 Google Workspace 的話,幾乎是零門檻。
要注意:
- Gemini 4 Argon 目前只開放給 Google 資安合作計畫(Fairwind)的夥伴,一般 API 與 Gemini App 都還用不到;Google 表示下一步會開放給付費 API 客戶與 Google AI Ultra 訂閱者,但尚未公布日期。
Grok(xAI)
xAI 是馬斯克創立的 AI 公司,目前的主力是 9 月 21 日推出的 Grok 4.7:
| 項目 | 內容 |
|---|---|
| API 價格 | 每百萬 token 輸入 2 美元、輸出 6 美元,同等級中最便宜的一群 |
| 即時資訊 | 可直接搜尋 X(前 Twitter)上的貼文,適合需要掌握即時輿論的應用 |
| 上下文長度 | 50 萬 token,雖不及 Gemini,但足以處理大部分文件 |
要注意:就我們的導入經驗,台灣企業目前較少把 Grok 當成主力模型,比較常見的用法是在開發者工具(例如 Cursor)中使用,或在重視成本的應用中作為備選。
也值得留意:Meta Muse Spark
Meta 過去以開放權重的 Llama 系列聞名,今年 4 月改推閉源的 Muse Spark 系列:
| 項目 | 內容 |
|---|---|
| 最新版本 | Muse Spark 1.3(9 月 2 日推出) |
| 實力 | Meta 宣稱程式測試勝過 GPT-5.6 Sol 與 Claude Opus 5(皆為上一代);在第三方綜合排名中僅次於前三大家族(見第 4 節) |
| API 價格 | 每百萬 token 輸入 1.25 美元、輸出 4.25 美元 |
| 取得方式 | Meta Model API(公開預覽)、Muse Code,以及 OpenRouter 等通路;Meta 表示之後會推出開放權重的版本 |
要注意:Meta Model API 開放給「多數提供 Meta AI 且支援付款的國家/地區」,各通路的可用地區、付款與帳號資格不同,台灣企業使用前請先依 Meta 最新的地域政策確認。企業級管理功能與雲端平台通路也還在起步,比較適合先觀察、小規模試用。
4. 綜合實力排名:目前誰最強?
各家都說自己最強,那有沒有一個中立的比較?最常被引用的,是獨立評測機構 Artificial Analysis 的「智力指數」(Intelligence Index):目前的版本(v4.3.2)綜合了 10 項測驗,涵蓋 Agent 任務、寫程式、一般知識與科學推理,合成一個綜合分數,並用同一套方法測所有模型。要注意的是,它以英文、文字任務為主,繁體中文與看圖等多模態能力不在這個分數裡。
以下是我們從 2026 年 10 月 7 日的榜單中,選出本文提到的 12 款模型(每個模型取它表現最好的設定;Claude 三款採用榜單上的「with fallback」設定,也就是遇到被安全機制拒絕的請求時,改由其他 Claude 模型完成):
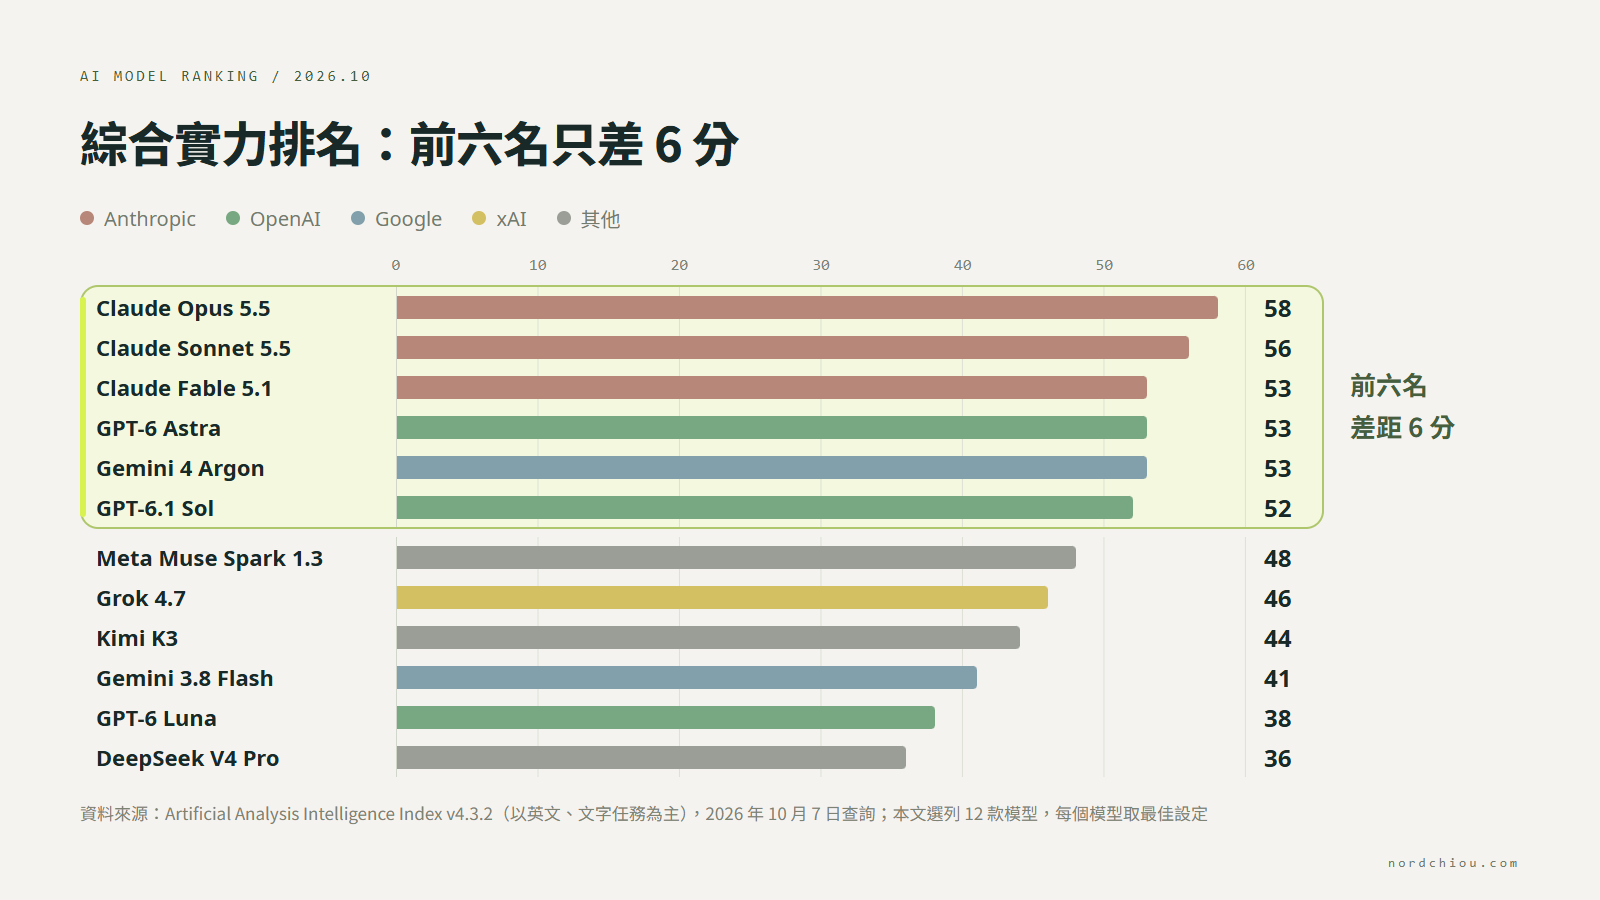
各模型的排序與等級如下(榜單上另有 MiMo-V2.6-Pro、Qwen3.8 Max、GLM-5.3 等 45~46 分的模型,本文未列入):
| 本表排序 | 模型 | 公司 | 綜合分數 | 備註 |
|---|---|---|---|---|
| 1 | Claude Opus 5.5 | Anthropic | 58 | 旗艦 |
| 2 | Claude Sonnet 5.5 | Anthropic | 56 | 中階 |
| 3 | Claude Fable 5.1 | Anthropic | 53 | 最高級 |
| 3 | GPT-6 Astra | OpenAI | 53 | 最高級 |
| 3 | Gemini 4 Argon | 53 | 最高級,目前有限開放 | |
| 6 | GPT-6.1 Sol | OpenAI | 52 | 旗艦 |
| 7 | Muse Spark 1.3 | Meta | 48 | 旗艦 |
| 8 | Grok 4.7 | xAI | 46 | 旗艦 |
| 9 | Kimi K3 | 月之暗面(Moonshot AI) | 44 | 開放權重 |
| 10 | Gemini 3.8 Flash | 41 | 中階 | |
| 11 | GPT-6 Luna | OpenAI | 38 | 輕量 |
| 12 | DeepSeek V4 Pro(0813 版) | DeepSeek | 36 | 開放權重 |
從這張表可以看出幾件事:
- 前六名只差 6 分:Anthropic、OpenAI、Google 的頂級模型幾乎並駕齊驅(這是這套綜合指數上的差距,不代表每項能力、繁中表現或企業任務都一樣接近)。這也是為什麼我們說「冠軍每幾個月就換一輪」,下一次新模型推出,排名很可能又會洗牌。
- 新一代的中階,可以勝過上一代的頂級:Opus 5.5 與 Sonnet 5.5 都是 9 月下旬才推出的新世代,分數反而高過等級更高、但早幾週推出的 Fable 5.1。同樣地,Google 2 月推出的旗艦 Gemini 3.1 Pro 只有 30 分(所以沒有列入上表),已被 9 月的 3.8 Flash(41 分)超越。看模型不能只看等級,也要看推出時間。
- 開放權重模型已經進入同一張表:Kimi K3 的分數已接近 Grok 4.7,和閉源前沿模型的差距正在縮小(第 7 節會再說明)。
怎麼看這張排名:綜合分數適合用來「縮小候選名單」,不適合直接拿來「決定用誰」。
表中分數是各模型表現最好的設定(多半是最高的推理強度),實際使用較快、較便宜的設定時,分數會比較低;而且這套指數以英文為主,標準化測驗也不一定代表你的工作。建議從前幾名裡挑兩三個,再用公司自己的任務實測(見第 8 節)。
5. 不是只有「最強的那一個」:每一家都分等級
前面提到,每一家都同時提供好幾個等級的模型。把它們放在一起看會更清楚:
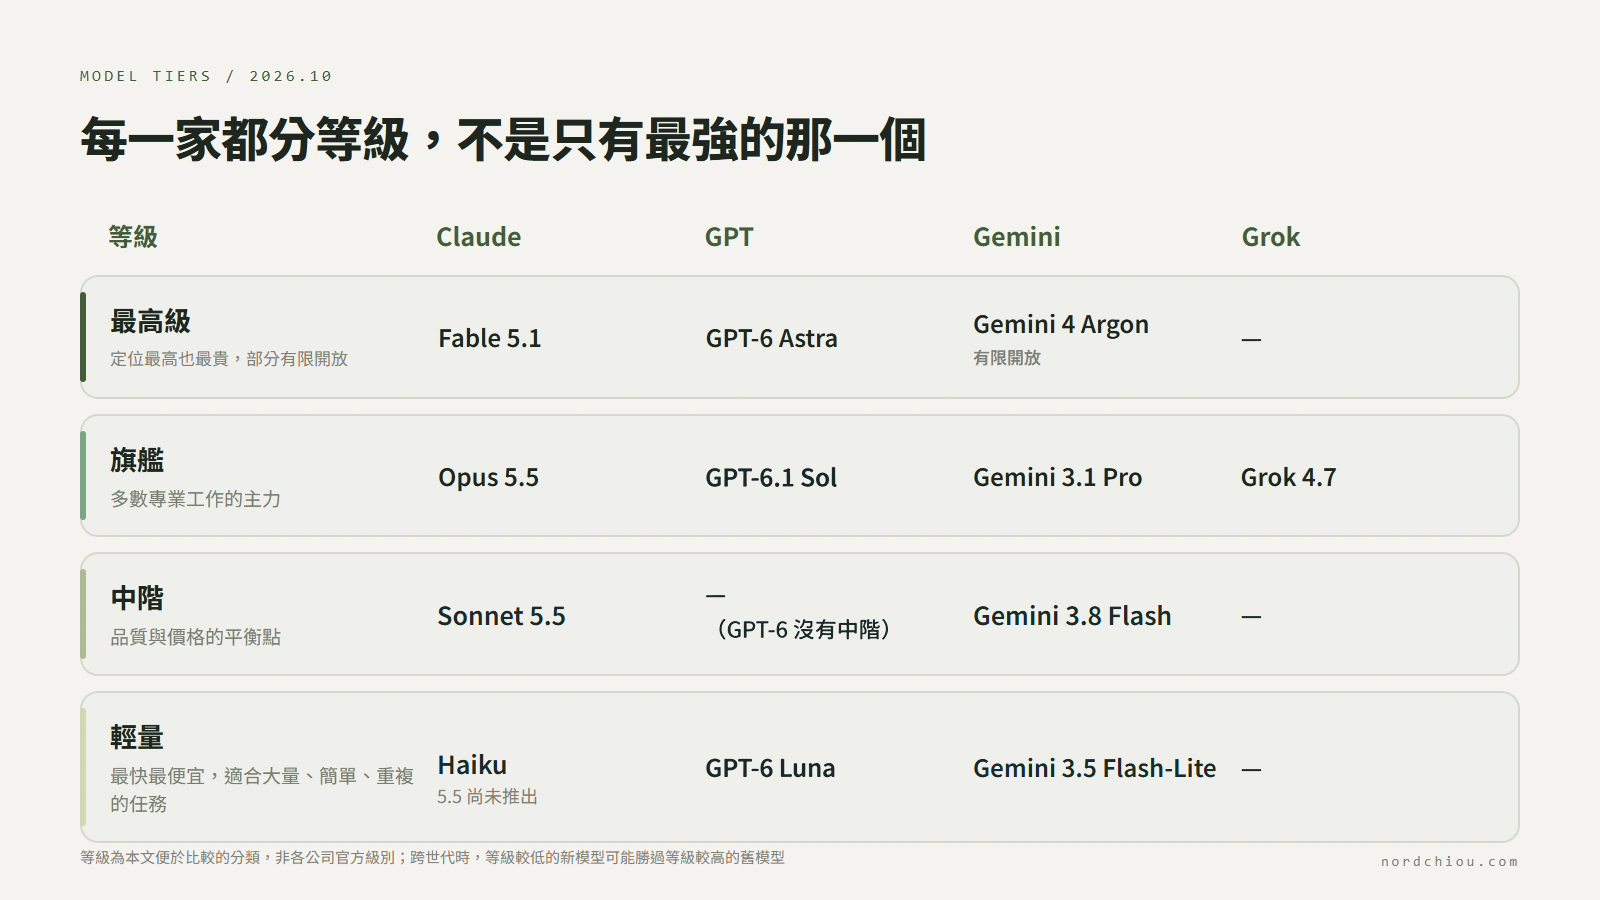
這裡的等級是本文為了方便比較的分類,不一定是各公司的官方級別。
為什麼要分等級?因為在同一家、同一代的模型裡,能力越強通常越貴、也越慢(跨世代就不一定,第 4 節的排名就是例子)。
API 是以 token 計費:token 是 AI 計算文字的單位,一個中文字粗估約一到兩個 token,依模型而異。輸入是你送給模型的內容,輸出是模型產生的內容(包含它思考時用掉的部分),輸出通常比較貴。不同等級的價格可以差到上百倍:
| 等級 | 模型 | 輸入 | 輸出 |
|---|---|---|---|
| 最高級 | Claude Fable 5.1 | 10 | 50 |
| 最高級 | GPT-6 Astra | 10 | 50 |
| 最高級 | Gemini 4 Argon | 4(首發優惠價 2) | 20(首發優惠價 10) |
| 旗艦 | Claude Opus 5.5 | 4 | 20 |
| 旗艦 | GPT-6.1 Sol | 2 | 10 |
| 旗艦 | Grok 4.7 | 2 | 6 |
| 旗艦 | Gemini 3.1 Pro(預覽版) | 2 | 12 |
| 旗艦 | Meta Muse Spark 1.3 | 1.25 | 4.25 |
| 中階 | Claude Sonnet 5.5 | 2 | 10 |
| 中階 | Gemini 3.8 Flash | 0.75 | 3.75 |
| 輕量 | GPT-6 Luna | 0.1 | 0.5 |
單位:每百萬 token,美元;為各家公布的標準 API 費率。
看價格表時要注意幾點:
- Gemini 4 Argon 的 API 尚未全面開放;依 Google 印尼官方部落格,首發優惠價適用到 2026 年 12 月 31 日,2027 年起為 4/20。
- Gemini 3.8 Flash 是 2026 年底前的價格,2027 年起調為 1.5/7.5。
- 長文本會加價:單次輸入達 20 萬 token 起(Grok 4.7)、超過 20 萬 token(Gemini 3.1 Pro)、超過 27.2 萬 token(GPT-6 Astra、GPT-6.1 Sol)時,整筆請求都會改用較高的費率(例如 Grok 4.7 變成 4/12;OpenAI 則是輸入 2 倍、輸出 1.5 倍)。
- 單價不等於總成本:前面提到 Opus 5.5「執行成本低約 40%」,指的是完成同樣工作的整體花費;實際帳單還會受模型思考時用掉的 token、重試次數影響,不能只看每 token 單價。
- 有折扣可用:重複送出相同內容可享快取(cache)折扣,不急的工作可用批次處理(batch)折扣,實際帳單會因用法而不同。
- Meta 的 Muse Spark 目前只有單一主力模型,所以沒有出現在上面的分級圖中。
實務建議:先用中階或旗艦模型把流程跑通,再看哪些步驟可以換成更便宜的模型。
例如一個 AI 客服 系統,「判斷客人問的是哪一類問題」這種簡單分類,用輕量模型就夠了;只有真正需要推理的複雜問題,才交給旗艦模型。這樣混用有機會大幅降低成本,但品質是否夠用,仍要用實際案例測過才知道。
6. 新趨勢:最強的模型,不一定拿得到
今年有一個特別值得留意的趨勢:最強的模型,一推出就「有限開放」。
| 公司 | 最強模型 | 目前開放對象 |
|---|---|---|
| Anthropic | Claude Mythos 5.1 | 透過受信任存取計畫開放給經審核的資安、生命科學個人與組織,目前僅限部分美國組織;一般版 Fable 有額外安全限制 |
| OpenAI | GPT-6 Astra | 推出初期分階段、先向少數組織(包括資安防禦計畫 Daybreak 的成員)開放;目前已提供給 ChatGPT 付費方案與 API,進階資安用途另有存取限制 |
| Gemini 4 Argon | 目前只開放給 Google 資安合作計畫(Fairwind)的夥伴;下一步是付費 API 客戶與 Google AI Ultra 訂閱者 |
原因很一致:這一代模型找出並利用軟體漏洞的能力已經強到,落到攻擊者手中會造成實際危害。所以各家選擇先讓防守方用,再逐步開放,並在高風險用途上加上限制。
這對企業有兩個實際意義:
- 「最新的模型」不等於「你能用的模型」。 看新聞時要留意它是正式推出、預覽,還是只開放給特定對象,以及在台灣能不能用。
- 資安的攻防節奏變快了。 攻擊者遲早也會拿到同等能力的工具,公司系統的更新與漏洞修補不能再拖。
7. 開放權重模型正在快速追上
另一股值得留意的力量是開放權重模型(open-weight model):公開模型的權重檔,可以下載到自己的伺服器上執行。它們常被通稱為「開源模型」,但訓練資料與程式碼不一定公開,授權條件也各有不同。
| 模型 | 公司 | 推出 |
|---|---|---|
| Kimi K3 | 月之暗面(Moonshot AI) | 7 月公開完整模型 |
| DeepSeek V4 Pro | DeepSeek | 4 月推出預覽版,8 月 13 日推出正式版 |
它們在部分測試中已經和閉源前沿模型互有勝負,API 價格通常也低得多。不過若要自己架設,硬體、維運與授權條件都會影響總成本,不一定比較便宜。對資料不能出公司、或用量非常大的企業來說,開放權重模型是值得認真評估的選項。這部分我們會在系列的下一篇詳細介紹。
8. 企業該怎麼選前沿模型?
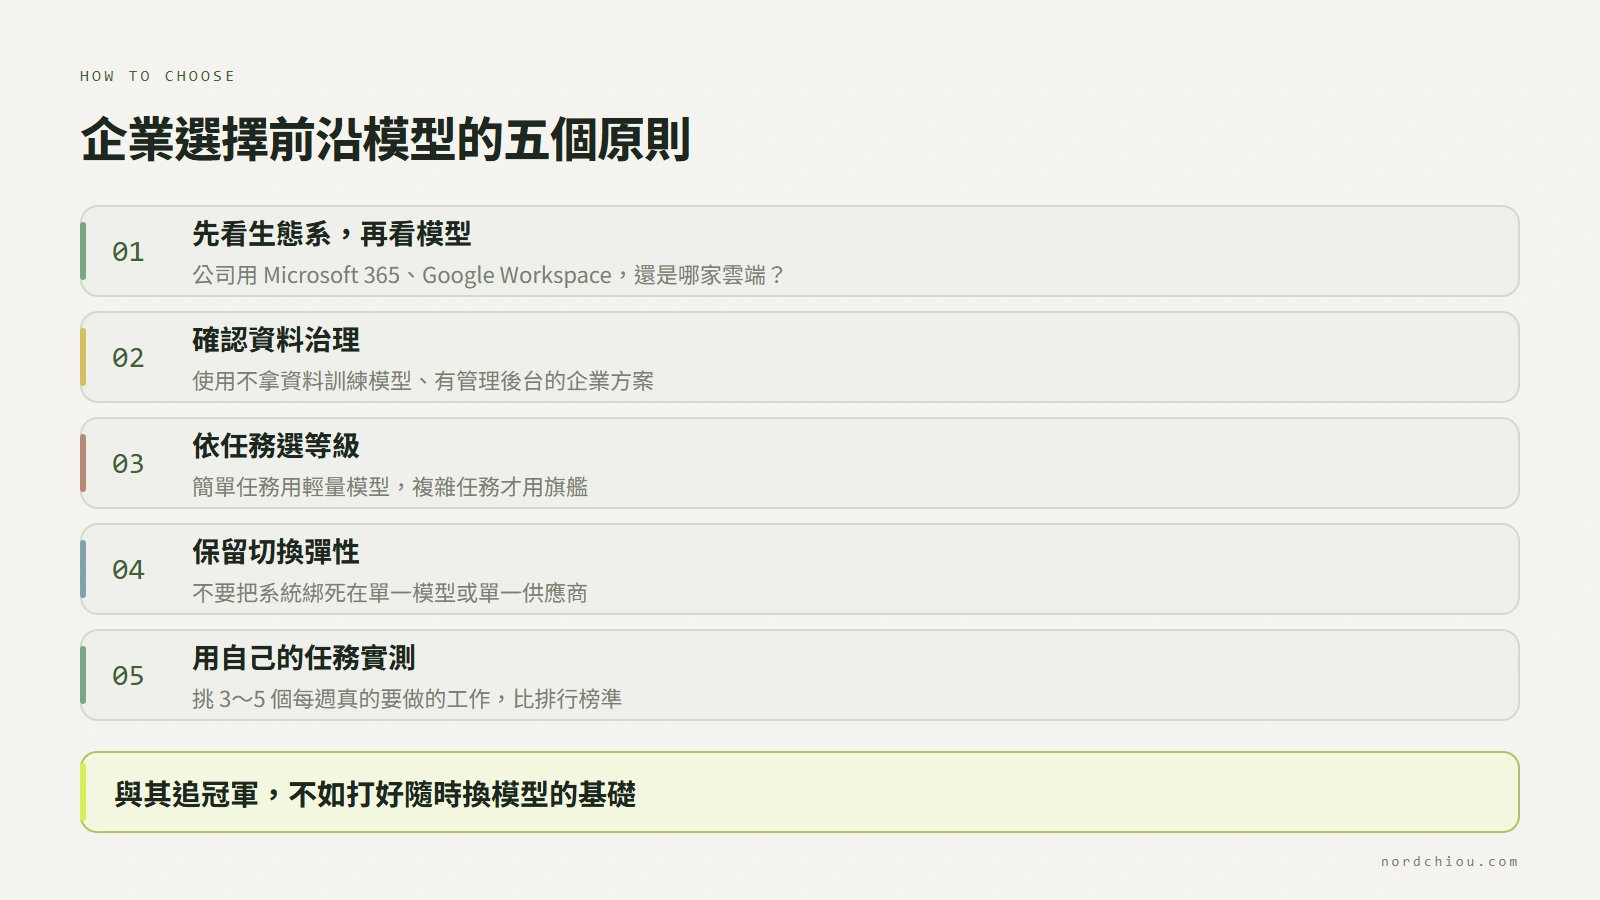
| 原則 | 具體做法 |
|---|---|
| 1. 先看生態系,再看模型 | 用 Microsoft 365 就從 Copilot 開始;用 Google Workspace 就從 Gemini 開始;已有 AWS 或 Azure 合約,就看上面有哪些模型。這通常是阻力最小、資安審查最快的路 |
| 2. 確認資料治理 | 使用公司核准的企業方案或 API,逐項確認:資料會不會拿去訓練模型、會保存多久、存放在哪個地區,以及有沒有管理後台控管帳號權限、留下稽核紀錄。員工各自用個人帳號處理公司資料,是常見的資料外洩風險 |
| 3. 依任務選等級 | 寫信、摘要、分類用中階或輕量模型就很好;複雜分析、寫程式、長時間的 Agent 任務,才值得用旗艦 |
| 4. 保留切換彈性 | 自行或委外開發 AI 應用時,要求系統能替換模型,並請開發方說明換模型需要多少時間與成本,避免被單一供應商綁住 |
| 5. 用自己的任務實測 | 排行榜是標準化測驗,不一定代表你的工作。挑三到五個每週真的要做的任務,讓兩三個模型各做一輪,結果往往一目了然 |
結語:與其追冠軍,不如打好隨時換車的基礎
九月短短四週,四家公司輪番推出新模型、各自宣稱第一。這份名單很可能在幾個月內又會更新。
對企業來說,比「現在選哪個最強」更重要的,是建立一套換模型也不會傷筋動骨的做法:
- 清楚的資料治理規範
- 可以替換模型的系統架構
- 一組能快速評估新模型的公司內部測試任務
有了這些,不論下一個冠軍是誰,你都能很快做出初步評估,決定要不要換。
如果你正在評估公司該用哪一家的模型,或是想知道現有的 AI 應用能不能改用更便宜的模型,可以從導入診斷開始:我們會盤點你們目前的工作流程、使用的系統與資料規範,建議適合的模型組合與導入順序。
參考資料
- Anthropic,〈Introducing Claude Opus 5.5〉,2026
- Anthropic,〈Introducing Claude Fable 5.1 and Claude Mythos 5.1〉,2026
- TechCrunch,〈Anthropic releases Opus 5.5 with lower prices and Fable-level performance〉,2026
- Anthropic,〈Introducing Claude Sonnet 5.5〉,2026
- SiliconANGLE,〈Anthropic debuts Claude Sonnet 5.5 running 30% faster than the previous-generation AI model〉,2026
- OpenAI,〈GPT-6 Astra〉,2026
- Constellation Research,〈OpenAI launches GPT-6 Astra〉,2026
- CNBC,〈OpenAI announces rollout of GPT-6 Astra model〉,2026
- TechCrunch,〈OpenAI launches GPT-6.1 Sol, says it nearly matches GPT-6 Astra and costs less〉,2026
- The New Stack,〈OpenAI releases GPT-6 Sol and Luna — and cuts token prices in half〉,2026
- OpenAI,〈GPT-6.1 Sol 模型文件〉、〈GPT-6 Astra 模型文件〉
- Wikipedia,〈GPT-5.6〉
- TechCrunch,〈Google releases Gemini 4 Argon, called its most powerful model yet〉,2026
- Google,〈Gemini 4 Argon(Google 印尼官方部落格)〉,2026
- Google,〈Gemini 3.8 Flash〉,2026
- eesel AI,〈Gemini 4 Argon: benchmarks, pricing, and how to get access〉,2026
- TechCrunch,〈Google releases three new Gemini models — but no 3.5 Pro〉,2026
- Wikipedia,〈Gemini (language model)〉
- xAI Docs,〈Grok 4.7〉
- MarkTechPost,〈SpaceXAI Releases Grok 4.7〉,2026
- The Next Web,〈OpenAI cancels October launch of GPT-6.1 Astra after failed safety tests〉,2026
- TechNode,〈Moonshot AI to make Kimi K3 available for public download〉,2026
- DeepSeek,〈API 更新紀錄〉
- DataNorth,〈DeepSeek releases V4-Pro-0813 and open sources Harness v0.1〉,2026
- Artificial Analysis,〈Intelligence Benchmarking Methodology〉
- Anthropic,〈Refusals and fallback〉
- Artificial Analysis,〈LLM Leaderboard〉,2026 年 10 月 7 日查詢
- Meta,〈Meta Model API 支援國家/地區〉
- Meta,〈Introducing Muse Spark 1.3〉,2026
- GIGAZINE,〈Metaが「Muse Spark 1.3」を発表〉,2026