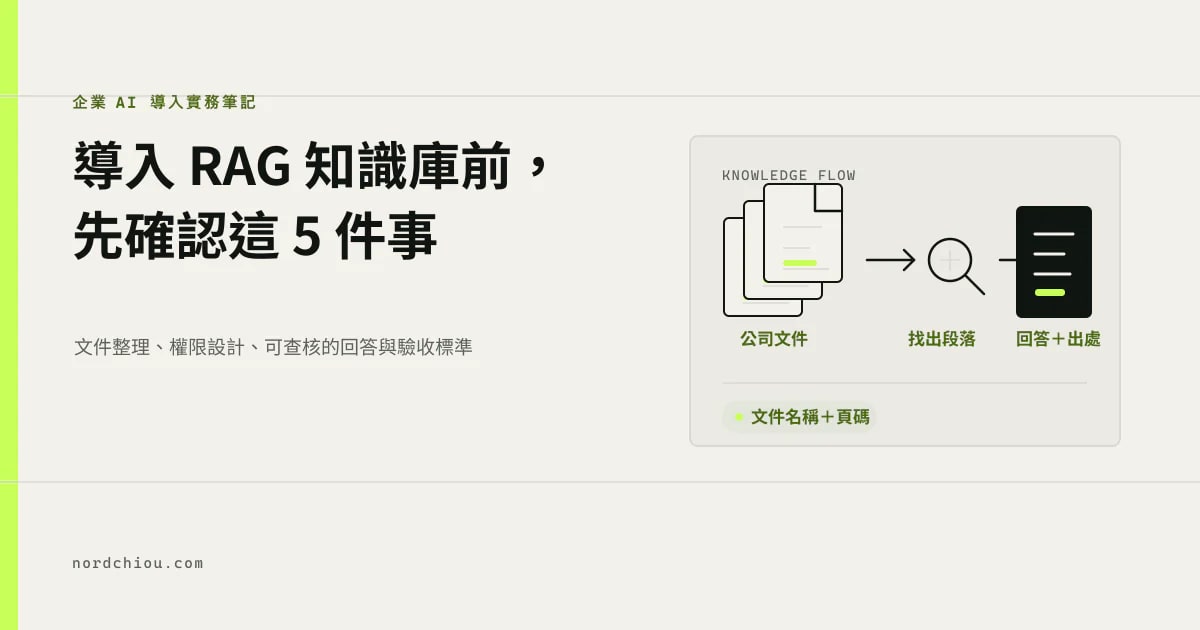
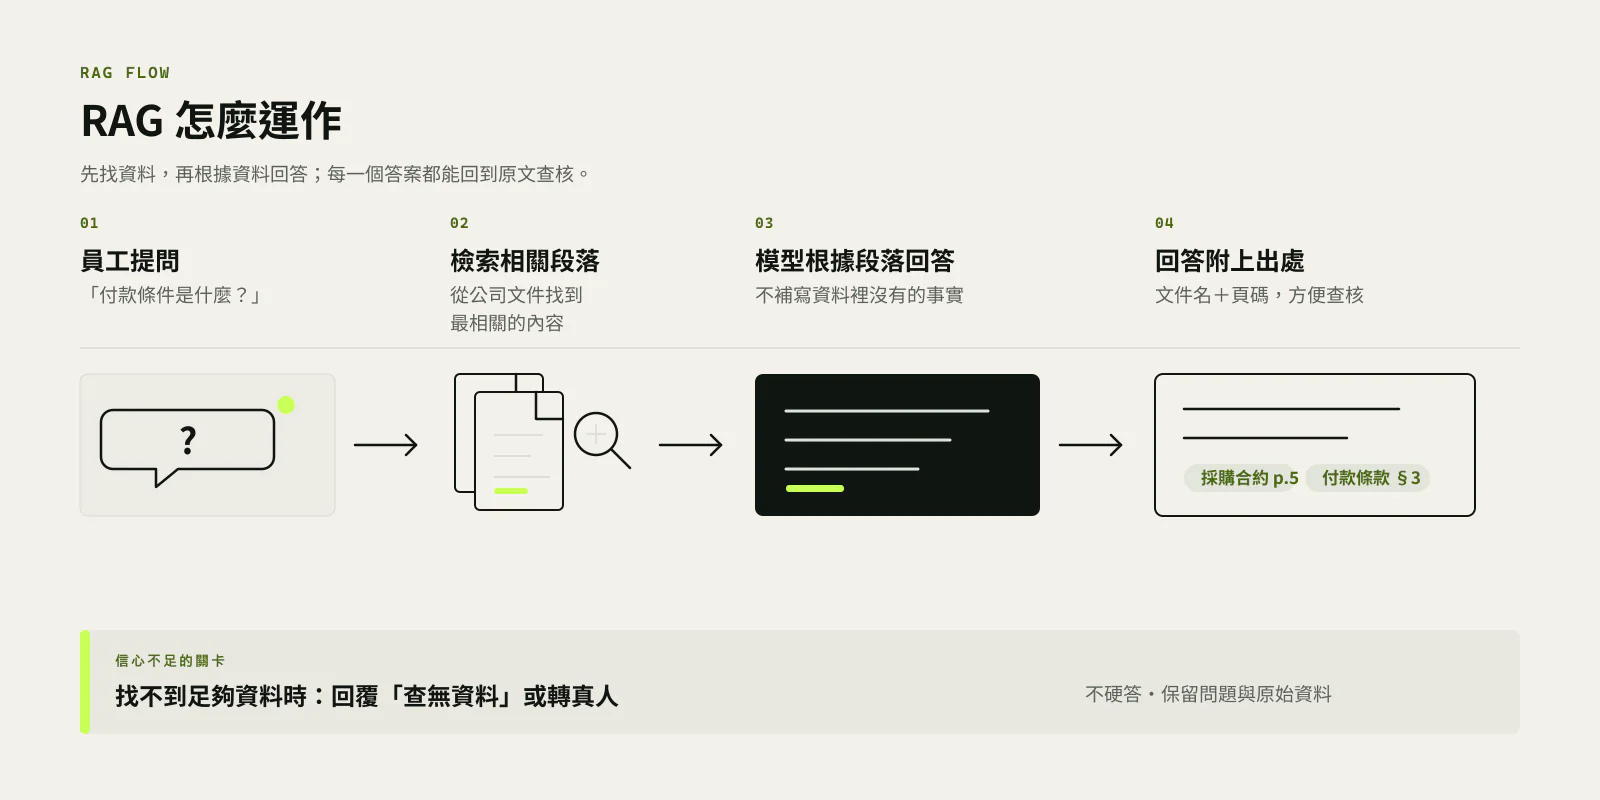
「把公司文件丟給 AI,讓同事直接問」——這是我們最常聽到的需求。這類系統通常稱為 RAG(Retrieval-Augmented Generation,檢索增強生成):先從你的文件中找出相關段落,再讓模型根據這些段落回答,並附上出處。
概念不難,但真正決定成敗的往往不是模型,而是導入前有沒有想清楚下面這 5 件事。
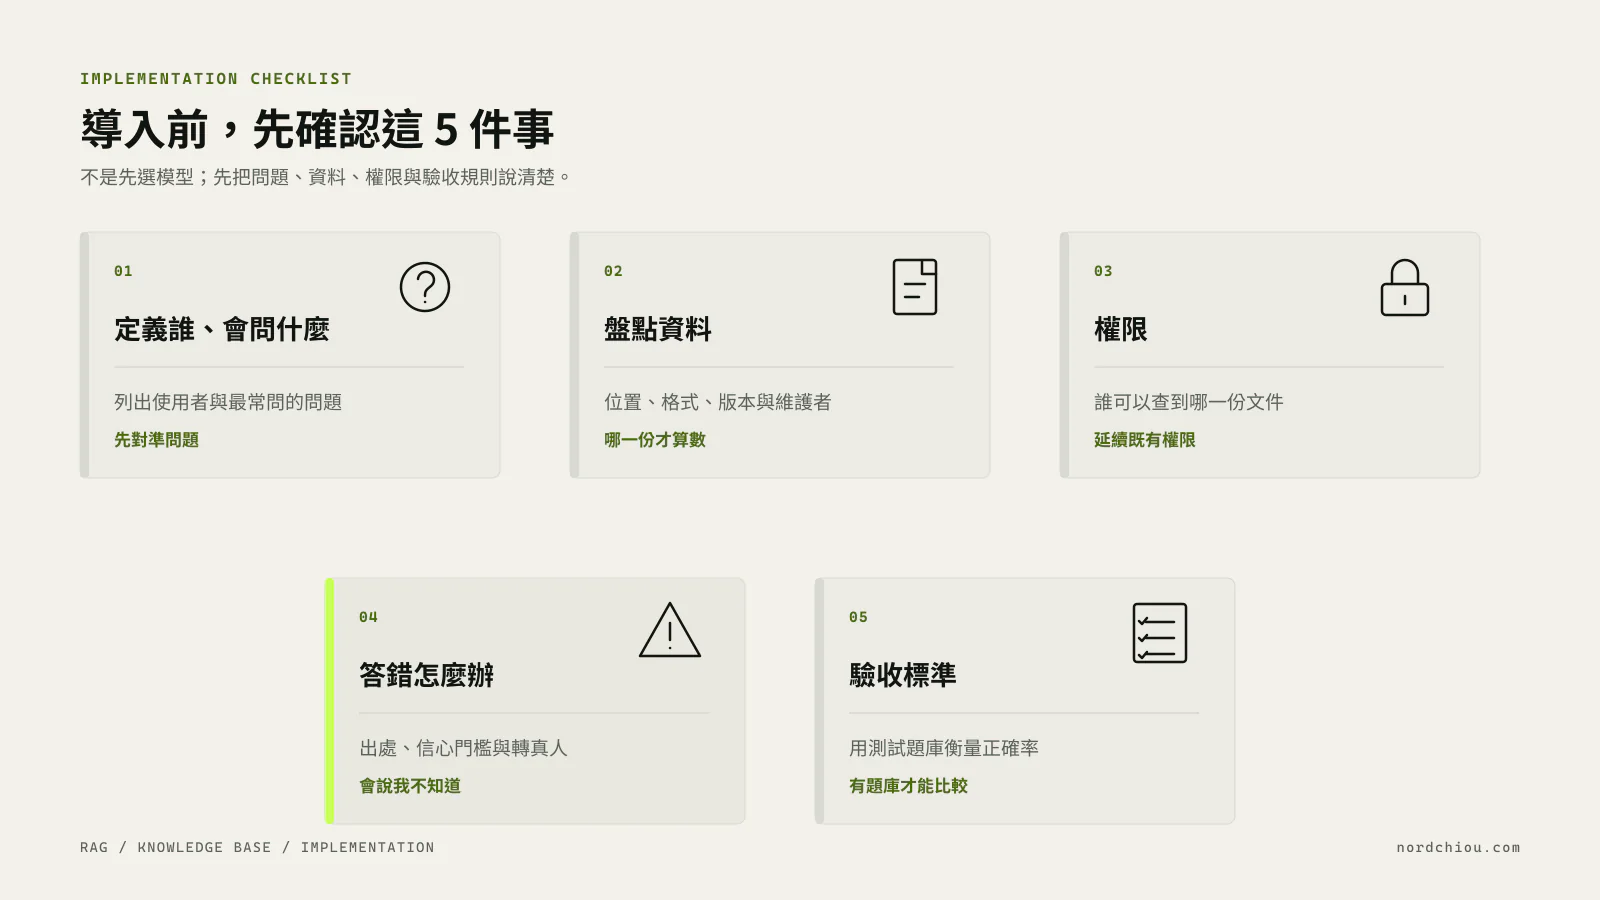
1. 先定義「誰、會問什麼問題」
知識庫不是越大越好,而是要對準一群人的一類問題。建議先寫下:
- 使用者是誰:業務、客服、品管,還是新進員工?
- 最常問的 20 個問題:直接從 LINE 群組、Email 或客服紀錄裡撈,不要憑想像。
- 現在怎麼找答案、花多少時間:這會是之後衡量導入成效的基準。
問題清單越具體,後面的資料整理、評測與驗收就越好做。
2. 盤點資料:在哪裡、是什麼格式、誰在維護
RAG 的回答品質,上限就是資料品質。導入前至少要知道:
| 項目 | 要確認的事 |
|---|---|
| 位置 | 共用資料夾、Google Drive、ERP、Notion,還是散落在個人電腦? |
| 格式 | Word、PDF、掃描檔、Excel、網頁?掃描檔需要額外做文字辨識 |
| 版本 | 同一份規格有沒有多個版本?哪一份才是最新的? |
| 維護者 | 文件更新時,誰負責、多久同步一次? |
資料不需要事先整理得很乾淨,但一定要知道「哪一份才算數」。否則 AI 很可能引用過期的版本,而且回答得很有自信。
3. 權限:不是每個人都能看到每份文件
內部文件通常有權限之分,例如人事規章人人可看,但薪資結構、報價底價只有特定部門能看。知識庫必須延續這些規則:
- 依部門或角色決定能檢索哪些文件
- 回答中不能出現使用者無權查看的內容
- 保留查詢紀錄,方便事後稽核
權限最好在規格階段就寫清楚,上線後再補,往往要重做索引。
4. 回答錯了怎麼辦:出處、信心門檻與轉真人
生成式 AI 仍然可能答錯,所以要設計「錯了也能被發現」的機制:
- 每個回答都附出處:文件名稱與頁碼,讓使用者可以點回原文查核。
- 信心不足時不硬答:找不到足夠相關的資料,就回覆「查無資料」或轉給負責人。
- 重要決策保留人工複核:例如報價、合約條款、醫療或法規相關內容。
一個會說「我不知道」的知識庫,比一個永遠有答案的知識庫更值得信任。
5. 驗收標準:用測試題庫說話
「感覺還不錯」不是驗收標準。建議在開發前就準備一份測試題庫:
- 從第 1 步的問題清單中挑出 30–50 題,寫下標準答案與應引用的文件。
- 每次調整資料、提示或模型後,都用同一份題庫重跑一次。
- 同時記錄正確率、出處是否正確,以及每題的回應時間與費用。
有了題庫,才能客觀比較不同做法,也才能在上線前確定「這一版可以用」。
小結:先把問題定義清楚,再談技術
這 5 件事其實都不是技術問題,而是流程與管理問題。把它們想清楚之後,模型與工具的選擇反而簡單很多。
如果你正在評估公司適不適合導入 AI 知識庫,可以從導入診斷開始:我們會一起盤點問題清單、資料現況與權限需求,再判斷值不值得進入開發。