上一篇〈前沿模型是什麼?〉介紹了 Claude、GPT、Gemini 這些閉源的頂級模型,文末提到另一股正在快速追上的力量:開放權重模型。
這也是客戶最常追問的兩個問題:
- 「AI 可以架在我們公司自己的伺服器上嗎?資料不想傳出去。」
- 「DeepSeek 不是說很便宜?可是政府不是禁止用嗎?」
先說結論:
開放權重模型的價值不在「免費」,而在「掌控權」:資料可以不出公司、可以依需求調整、不被單一供應商綁住。但代價是硬體、維運與授權審查都要自己負責。至於中國模型,關鍵在分清楚你是「把資料送到對方的服務」,還是「在自己的環境執行模型」,兩者的風險完全不同。
這篇是「AI 模型種類」系列的第二篇。
本文資訊截至 2026 年 10 月 8 日。模型與授權條件更新很快,使用前請以各家官方公告為準。
1. 什麼是開放權重模型?
AI 模型最核心的部分是「權重」(weights):模型訓練後得到的一大組數值參數,通常分成多個檔案,大型模型合計動輒數百 GB 到數 TB。模型的「參數量」指的就是這些數值有多少個,可以反映模型規模,但不是能力的唯一指標。開放權重模型(open-weight model)就是把權重檔公開,讓任何人下載到自己的電腦或伺服器上執行。
用汽車來比喻:
- 閉源模型像叫計程車:隨叫隨到、不用保養,但車子不是你的,路線和價格由車行決定,你的行程車行也看得到。
- 開放權重模型像買一台車:要自己準備車庫、加油、保養,但車子是你的,想開去哪就去哪,也可以自己改裝。
開放權重常被通稱為「開源模型」,但兩者不完全相同:
| 類型 | 公開什麼 | 代表 |
|---|---|---|
| 閉源模型 | 權重不公開下載,只能透過 API 或產品使用(可能公開技術報告) | Claude、GPT、Gemini |
| 開放權重模型 | 公開權重檔,可以下載執行;訓練資料與訓練程式通常不公開 | DeepSeek、Qwen、Kimi、Gemma |
| 完整開源模型 | 除了權重,也提供訓練程式與充分的訓練資料資訊,方便研究、修改與重建 | 艾倫人工智慧研究所的 Olmo 等研究型模型 |
市面上絕大多數被稱為「開源」的模型,其實是開放權重模型。這個差別在評估授權與風險時很重要,第 4 節會再說明。
2. 企業為什麼在意開放權重?
| 優點 | 說明 |
|---|---|
| 資料不出公司 | 模型在企業自己控制的環境執行,提問與回答不必經過模型原廠,適合病歷、合約、設計圖這類敏感資料 |
| 大量使用時成本可控 | 按 token 計費的 API 用得越多越貴;自己架設則主要是硬體與電費,用量很大時可能更划算 |
| 可以客製 | 可以用公司資料再訓練(微調,fine-tuning),讓模型更懂你的產業用語與格式 |
| 不被綁住 | 原廠漲價、改版或停止服務,都不會影響已經下載的模型 |
| 可以離線運作 | 工廠、醫院、軍工等無法連外網的環境也能使用 |
但代價也很明確:
- 硬體門檻高:最強的開放權重模型動輒超過 1T(一兆)個參數,通常需要多張高階 GPU(適合 AI 運算的處理器;資料中心等級的 GPU 和一般電腦的顯示卡在容量、價格上差很多)才跑得動(第 5 節會說明)。
- 維運要自己扛:安裝、更新、監控、資安防護,都需要有人負責。
- 能力仍有差距:在第三方綜合評測中,最強的開放權重模型大約落後閉源頂級模型 10 分以上(見下一節)。
- 授權與來源要審查:有些授權附帶條件,中國模型還有額外的合規考量(第 4、6 節)。
3. 2026 年主要的開放權重模型
大型模型:中國陣營領先
規模的單位:B(billion)是十億,T(trillion)是一兆;例如 42B=420 億、1.02T=1.02 兆。
| 模型 | 公司 | 推出 | 規模(總參數/每次啟用) | 授權 | 綜合分數 |
|---|---|---|---|---|---|
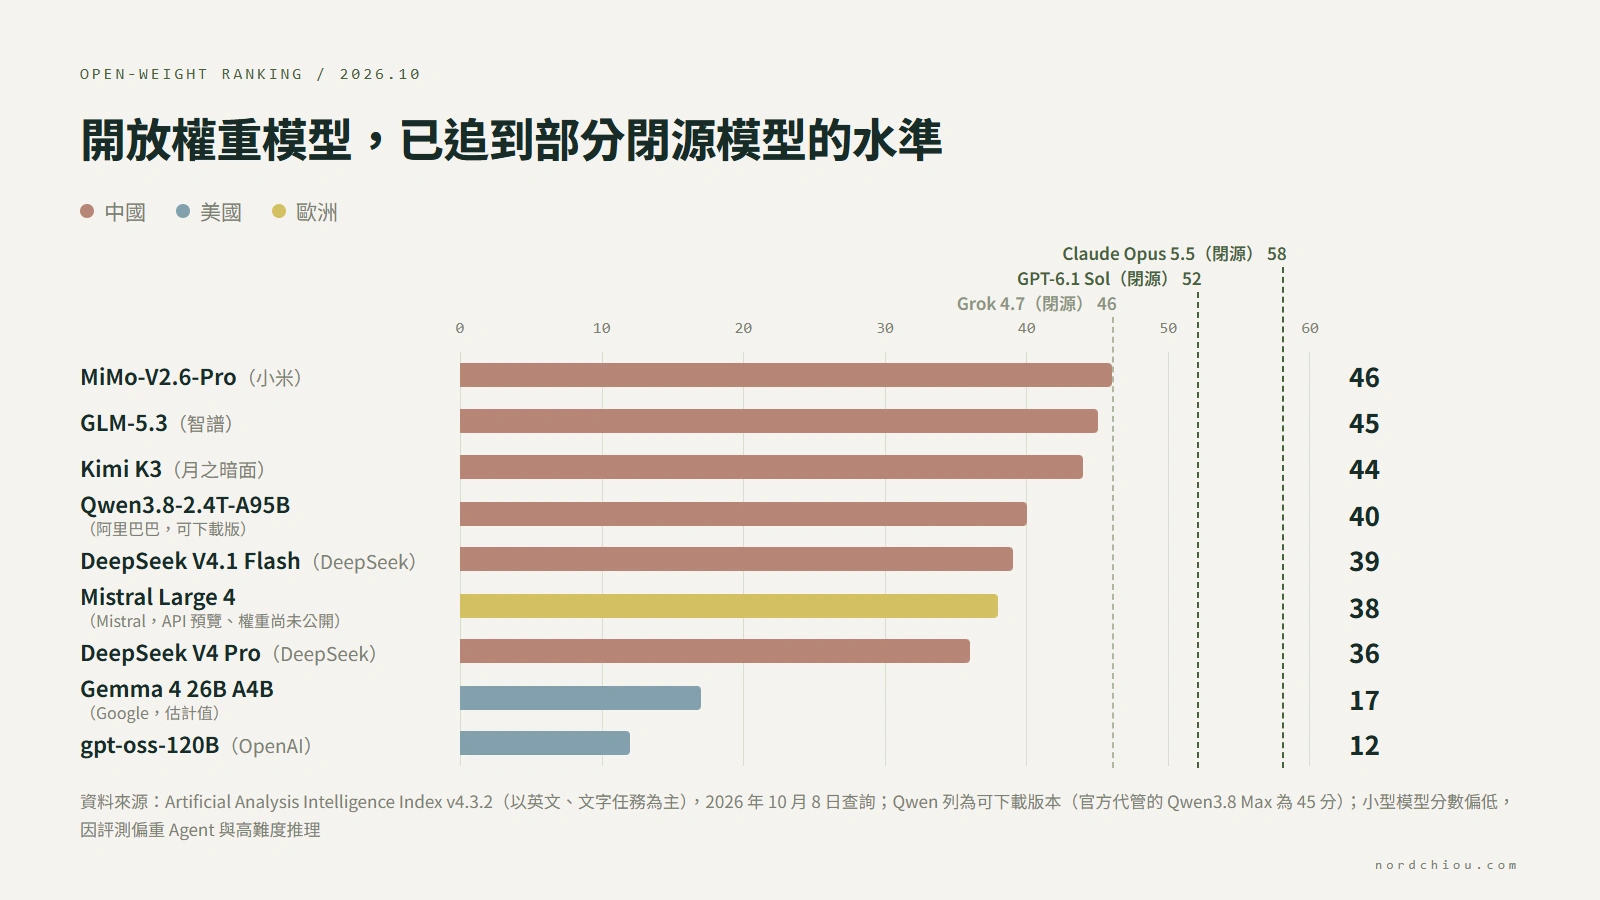
| MiMo-V2.6-Pro | 小米(中國) | 9 月 21 日 | 1.02T/42B | MIT | 46 |
| GLM-5.3 | 智譜 Z.ai(中國) | 8 月 28 日 | 753B/未列 | 自訂授權 | 45 |
| Kimi K3 | 月之暗面(中國) | 7 月 27 日公開權重 | 2.8T/104B | Kimi K3 自訂授權 | 44 |
| Qwen3.8-2.4T-A95B | 阿里巴巴(中國) | 8 月 12 日 | 2.4T/約 95B | 自訂授權 | 40 |
| DeepSeek V4.1 Flash | DeepSeek(中國) | 9 月 10 日 | 552B/輸入 8B、輸出 16B | MIT | 39 |
| Mistral Large 4 | Mistral(法國) | 10 月 6 日 API 預覽,權重預計 10 月底公開 | 1.05T/52B | 權重授權尚待公布 | 38(預覽版) |
| DeepSeek V4 Pro | DeepSeek(中國) | 4 月預覽、8 月 13 日正式版 | 1.6T/49B | MIT | 36 |
綜合分數為 Artificial Analysis Intelligence Index v4.3.2,2026 年 10 月 8 日查詢,以英文、文字任務為主。作為對照,閉源的 Claude Opus 5.5 為 58 分、GPT-6.1 Sol 為 52 分、Grok 4.7 為 46 分。Qwen 列的是可下載的版本;阿里巴巴以它為基礎、加上看圖與內建工具等功能的官方代管版 Qwen3.8 Max 為 45 分,但無法下載自架。
從這張表可以看出:
- 前段班幾乎都是中國模型:最強的開放權重模型(MiMo-V2.6-Pro,46 分)已經和閉源的 Grok 4.7 同分,但和 Claude Opus 5.5(58 分)仍有一段距離。
- 美國大廠的開放權重以小型為主:Meta 今年把主力轉向閉源的 Muse Spark;OpenAI 的 gpt-oss 與 Google 的 Gemma 4 都是可以在單台機器上執行的小型模型。
- 歐洲的代表是 Mistral:Large 4 目前只開放 API 預覽,權重預計 10 月底公開,授權條款也還沒公布。
「總參數/每次啟用」是什麼意思?
表格裡的規模寫成兩個數字,例如 MiMo-V2.6-Pro 是「1.02T/42B」。這是因為這些大型模型多半採用混合專家(Mixture of Experts,MoE)架構:模型內部分成很多組「專家」,各自擅長不同類型的內容。
模型產生回答時,是一個字、一個字(精確地說是一個 token)往下寫。每寫一個字,模型會先判斷「這個字需要哪幾組專家」,只讓那幾組參與計算,其他專家這一步就休息;下一個字再重新挑一次。
| 數字 | 意思 | MiMo-V2.6-Pro 的例子 | 影響什麼 |
|---|---|---|---|
| 總參數 | 模型裡所有專家加起來的參數量 | 1.02T | 需要多大的記憶體來存放模型 |
| 每次啟用 | 每產生一個字時,實際參與計算的參數量 | 42B(約總數的 4%) | 每個字要算多久,也就是回答速度與運算成本 |
用醫院來比喻:一家醫院有上百位各科醫師(總參數),但每位病人掛號時,只會由相關的兩三位醫師看診(每次啟用)。所以病人等待的時間,取決於實際看診的醫師,而不是全院醫師人數。
這帶來一個常被誤解的結果:
- 速度看「每次啟用」:MiMo-V2.6-Pro 雖然有 1.02T 參數,每個字只需要動用 42B 參數來計算,所以回答速度比同樣大小、每次都要全部參與的模型快很多。
- 硬體看「總參數」:因為每個字需要的專家都不一樣,所有專家都必須隨時待命。要維持速度,通常得把整個模型(1.02T 參數)都載入記憶體;雖然可以把一部分放到較慢的記憶體來降低 GPU 需求,代價是速度變慢。
換句話說,MoE 讓大型模型「跑得比較快」,但沒有讓它「需要的硬體變少」。這也是為什麼第 5 節的大型模型,仍然需要多張 GPU 的伺服器。
小型模型:可以先評估單機部署
| 模型 | 公司 | 推出 | 規模 | 授權 | 特色 |
|---|---|---|---|---|---|
| Gemma 4 | Google(美國) | 4 月發表,6 月新增 12B | E2B、E4B、12B、26B A4B、31B 五款(E 代表有效參數規模) | Apache 2.0 | 支援圖片與影片輸入,小尺寸可在手機、筆電上執行 |
| gpt-oss | OpenAI(美國) | 2025 年 8 月 | 117B(gpt-oss-120B)、21B(gpt-oss-20B) | Apache 2.0 | 以官方的壓縮格式,120B 可在單張 80GB GPU 執行,20B 約需 16GB 記憶體 |
| TAIDE(Gemma-3-TAIDE-12b-Chat-2602) | 國科會(台灣) | 2026 年 2 月 | 約 12B(以 Google Gemma 3 為基礎) | TAIDE 模型授權(以 Gemma 為基礎的版本) | 針對繁體中文與台灣在地文化、用語加強訓練 |
本文為了方便比較,把可以單機部署的模型歸為「小型」;gpt-oss-120B 的參數量其實已超過 100B,第 5 節的硬體表會再細分。
小型模型在綜合評測上的分數低很多(例如 Gemma 4 26B A4B 約 17 分,為評測機構的估計值;gpt-oss-120B 為 12 分),因為這套評測偏重長時間的 Agent 任務(會自己規劃步驟、使用工具把事情做完的 AI)與高難度推理。但對摘要、分類、翻譯、資料擷取、客服問答這類範圍明確的工作,小型模型往往已經夠用,也可以先評估單機部署,是企業自架最實際的起點。
4. 授權不只是「免費」:先看清楚條件
開放權重不代表「想怎麼用都可以」。2026 年的一個明顯趨勢是:大型模型越來越常使用附帶條件的自訂授權。
| 授權類型 | 代表模型 | 主要條件 |
|---|---|---|
| Apache 2.0、MIT(寬鬆授權) | Gemma 4、gpt-oss、MiMo-V2.6、DeepSeek V4 系列 | 通常可商用、可修改;再散布時須保留授權與相關聲明,Apache 2.0 另有標示修改處、保留 NOTICE 檔等要求 |
| 自訂授權(標示與營收門檻) | Kimi K3 | 商業產品月活躍用戶超過 1 億或月營收超過 2,000 萬美元,須在介面顯著標示 Kimi K3;以模型對外提供服務(Model as a Service)、連續 12 個月營收合計超過 2,000 萬美元者,須另與月之暗面簽約。內部使用等情況另有例外 |
| 自訂授權(標示與營收門檻) | Qwen3.8-2.4T-A95B | 產品月活躍用戶超過 1 億或月營收超過 2,000 萬美元,須顯著標示模型名稱;經營模型服務、AI 寫程式或辦公助理類產品,且企業與關係企業連續 12 個月合計營收超過 5,000 萬美元者,須另外取得授權。不對第三方提供的內部使用不受此限 |
| 自訂授權(安全審查) | GLM-5.3 | 企業與關係企業經營模型服務業務、連續 12 個月合計營收超過 100 億美元者,商用前須通過 Z.ai 的安全審查;授權未列具體審查標準,範圍與方式由 Z.ai 決定 |
| 基礎模型+在地授權 | TAIDE | 須接受 TAIDE 模型授權;以 Gemma 為基礎的版本,也要留意基礎模型的使用條款 |
| 尚待公布 | Mistral Large 4 | 前一代 Large 3 為 Apache 2.0;Large 4 的權重授權要等正式釋出時才會公布 |
對大多數台灣企業的內部使用來說,這些營收與用戶門檻不容易觸及;但如果你要把模型包進產品或服務對外販售,就必須逐條確認。有兩件事一定要做:
- 導入前請法務看過授權全文:本文只是摘要,條款中的「模型服務」「關係企業」等定義與例外,都會影響是否適用。
- 同一家公司的不同尺寸,授權可能不同:例如 GLM-5.3 的較小版本 GLM-5.3-Flash 是 MIT,旗艦版卻是自訂授權。
5. 三種使用方式:資料去哪裡差很多
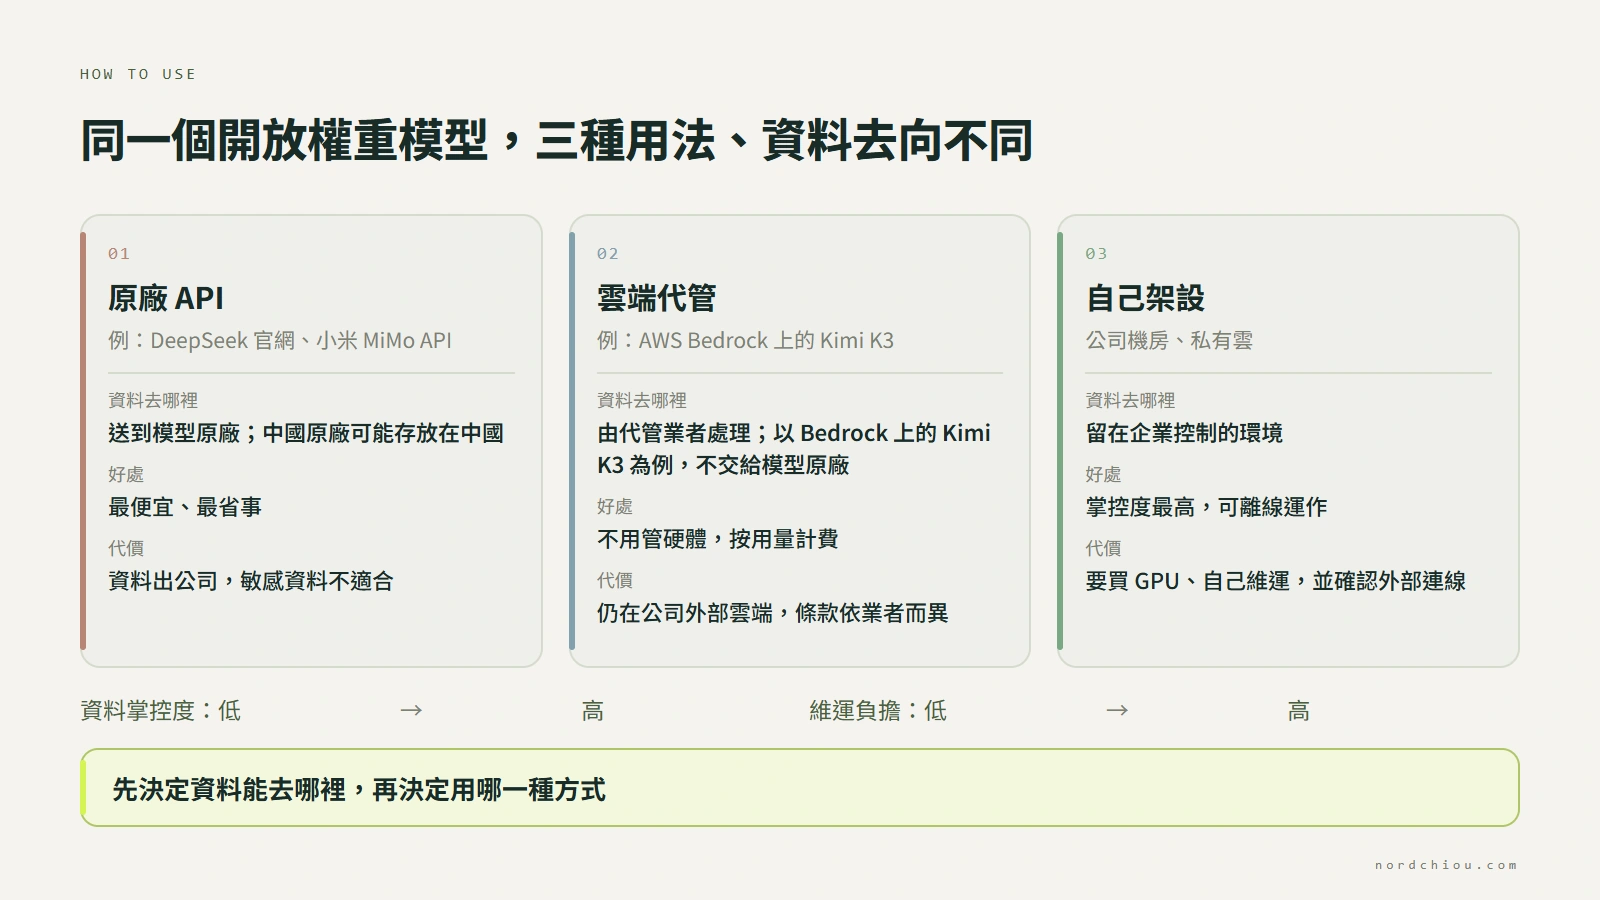
同一個開放權重模型,可以用三種完全不同的方式使用:
| 使用方式 | 資料去哪裡 | 成本與門檻 | 適合 |
|---|---|---|---|
| 原廠 API(例如 DeepSeek 官網、小米 MiMo API) | 送到模型原廠的伺服器;中國原廠的資料可能存放在中國、受中國法律管轄 | 部分模型價格很低、最省事,按用量計費 | 使用公開或測試資料、不含敏感資料的評估 |
| 雲端代管(例如 AWS Bedrock) | 由代管業者處理;會不會交給模型原廠、保存多久、在哪個地區處理,依各業者條款而定 | 按用量計費,不用管硬體 | 想用開放權重模型、又不想自己維運的企業 |
| 自己架設(公司機房、私有雲) | 留在企業控制的環境;但若系統另外串接外部搜尋或監控服務,資料仍可能外流,要一併確認 | 要買或租 GPU,並有人負責維運 | 資料最敏感、用量大、或需要離線運作的場景 |
以 Kimi K3 為例:它在 9 月 18 日上架 AWS Bedrock,AWS 說明推論資料不會分享給月之暗面、預設不保留、也不會被拿去訓練模型。同一個模型,透過 Bedrock 使用和直接用月之暗面的 API,資料的去向完全不同。要注意的是,這是 AWS 針對這項服務的承諾,不代表所有代管業者都一樣;選用「全球跨區」設定時,資料也可能在其他國家的機房處理。
自己架設要多少硬體?
這是最常被低估的部分。粗略的參考:
| 模型規模 | 代表 | 大約需要 |
|---|---|---|
| 小型(20B 上下) | gpt-oss-20B、Gemma 4 小尺寸 | 以官方壓縮格式,約 16GB 記憶體的單機或單張顯示卡可以執行 |
| 中型(100B 上下) | gpt-oss-120B | 單張 80GB 的資料中心級 GPU |
| 大型(數百 B 到數 T) | GLM-5.3、Kimi K3、DeepSeek V4 Pro | 通常需要多張高階 GPU 的伺服器;例如依 Unsloth 的部署指南,GLM-5.3 以 8-bit 壓縮執行,GPU 顯示記憶體加系統記憶體合計約需 810GB,若要兼顧速度,GPU 顯示記憶體佔比越高越好 |
註:以上是單機執行的參考,不代表能同時服務很多人。實際需求還會受壓縮方式(量化,quantization)、同時使用人數與文本長度影響,正式採購前請以實測為準。
一台能跑大型模型的 GPU 伺服器動輒數百萬到上千萬台幣,再加上電費與維運人力。除非用量非常大、或資料絕對不能出公司,否則多數企業先從雲端代管或小型模型開始,會比較划算。
6. 中國模型能不能用?
這是台灣企業最常問、也最需要說清楚的問題。
公務機關與政府採購:數位發展部在 2025 年 1 月底示警,行政院隨後要求公務機關全面禁用 DeepSeek 的 AI 服務,範圍包含雲端服務、App 與地端下載,也就是公務機關即使自己架設也不能用;官方理由是資安風險與資料可能跨境傳輸。教育部也禁止公立學校採購使用大陸廠牌的資通訊產品。此外,行政院公共工程委員會在 2025 年 5 月函請各機關,在採購契約中禁止廠商使用 DeepSeek 製作書面履約成果,並禁止履約時使用大陸廠牌資通訊產品,違反者機關可以終止或解除契約。
一般民間使用:政府目前沒有限制民間業者與一般民眾使用,但提醒使用時應注意資安與隱私風險。如果你的公司承接政府標案,就要特別留意契約條款,這些限制可能也會套用到你身上。
但「能用」不等於「適合用」。建議分成三個層次來看:
| 風險 | 用原廠 App/API | 自己架設或雲端代管 |
|---|---|---|
| 資料傳到中國 | 有風險:資料存在對方伺服器,受中國法律管轄 | 資料不經過原廠,這項風險大幅降低(仍要確認代管業者條款與系統的外部連線) |
| 回答內容的偏差 | 可能有:服務端的過濾機制,加上模型本身的訓練,都可能影響特定政治、歷史議題的回答 | 可能仍有:已有研究發現,部分中國模型在本地執行時,對政治敏感議題仍會拒答或迴避;程度因模型、版本與設定而異,自架不會自動消除,須實際測試 |
| 客戶與法規要求 | 公務機關、政府採購契約、部分大型客戶的合約可能明文禁止 | 同樣可能被禁止:例如公務機關的禁用範圍就包含地端下載,要看規定與合約對「大陸廠牌資通訊產品」的定義 |
實務上的建議:
- 承接政府標案、或客戶合約有明確要求的,直接避開,選擇美歐或台灣的模型。
- 一般企業內部使用,若選擇中國模型,在完成資料與契約審查前,不要把敏感、個人、機密或客戶資料送進原廠的 App 或 API;正式使用時,透過雲端代管或自己架設。
- 用在對外服務前,先建立測試題庫:準備與業務相關、涵蓋不同問法的題目(包含可能觸及兩岸、政治議題的情境),檢查回答的事實正確性、來源、偏差與拒答情形;高風險的輸出要有人工覆核。公司的對外溝通原則另行訂定。
7. 企業怎麼選開放權重模型?
| 步驟 | 要問的問題 | 怎麼決定 |
|---|---|---|
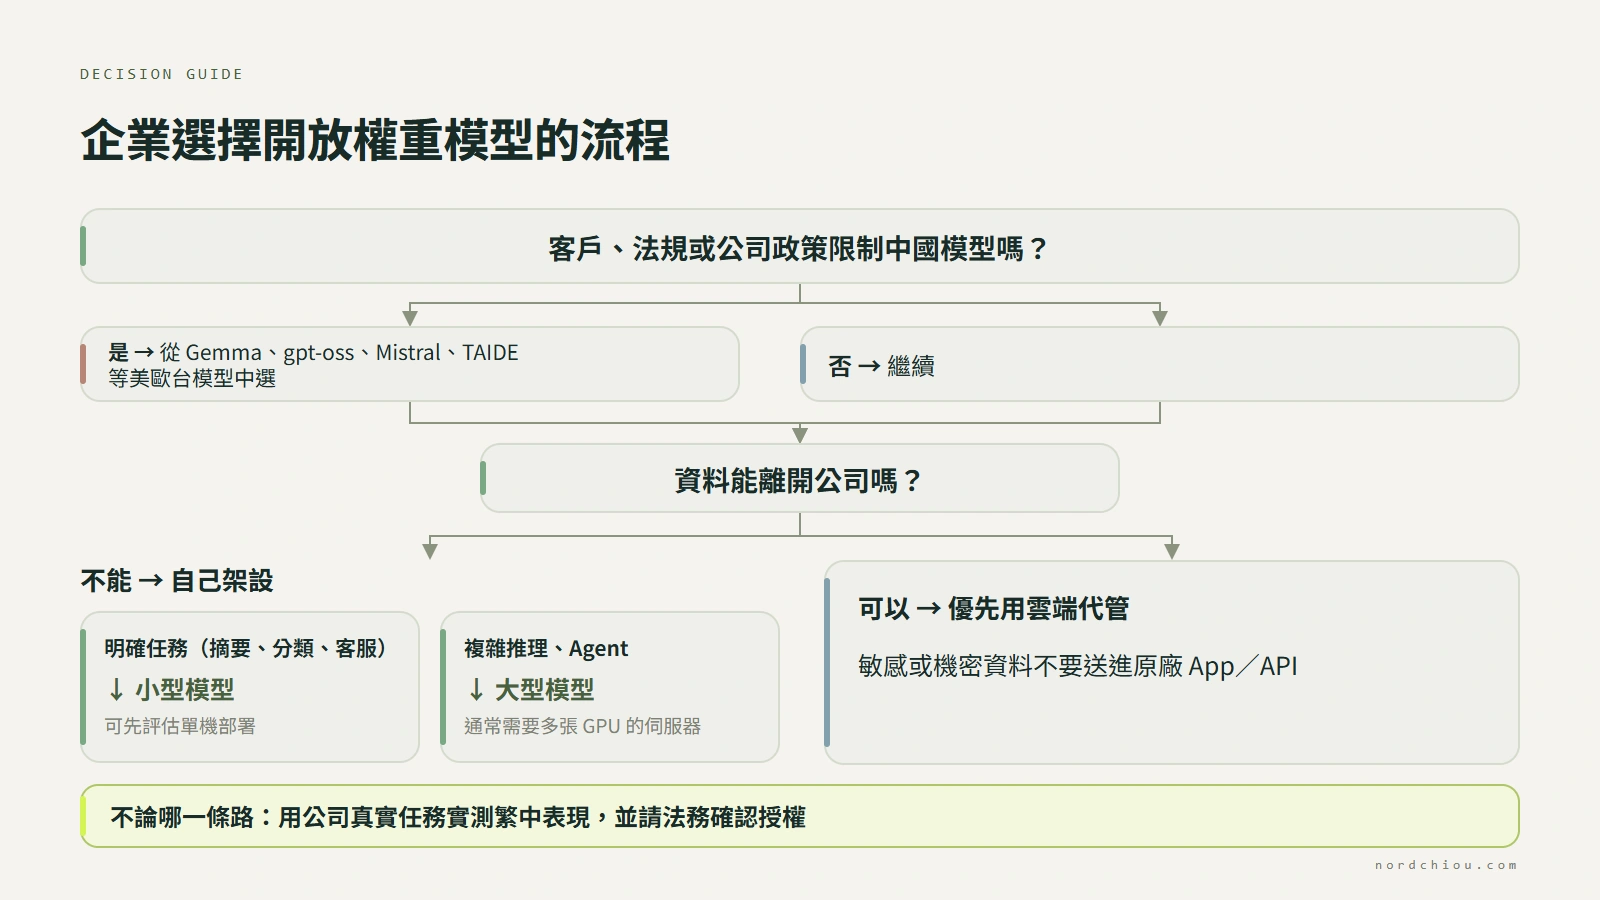
| 1. 先確認限制 | 客戶合約、法規或公司政策,是否限制使用中國模型? | 有限制就從 Gemma、gpt-oss、Mistral、TAIDE 等模型中選 |
| 2. 決定資料去向 | 資料能不能離開公司? | 不能就自己架設;可以但不想交給原廠,就用雲端代管 |
| 3. 評估規模 | 任務是摘要、分類這類明確工作,還是複雜推理與長時間 Agent 任務? | 明確任務先試小型模型;複雜任務才考慮大型模型,或乾脆用閉源前沿模型 |
| 4. 審查授權 | 授權有沒有用戶數、營收或標示條件? | 請法務看過全文,特別是要包進產品對外販售時 |
| 5. 用自己的任務實測 | 繁體中文表現、專業用語、回答格式是否符合需求? | 綜合分數以英文為主,繁中表現一定要自己測 |
很多企業最後的答案會是混搭:一般工作用閉源前沿模型(透過企業方案),敏感資料或大量重複的任務,再交給自己架設或雲端代管的開放權重模型。
結語:開放權重是「多一個選項」,不是「取代閉源」
2026 年的開放權重模型已經強到不能忽視:最強的幾款已經和部分閉源前沿模型同分,部分模型的 API 價格也明顯較低,還能讓資料留在企業自己控制的環境。
但它不是免費的午餐。硬體、維運、授權審查與來源風險,都是導入前要算進去的成本。對多數企業來說,比較務實的路徑是:
- 先用雲端代管或小型模型驗證效果
- 確認值得之後,再評估是否投資自己的 GPU 伺服器
- 讓閉源與開放權重模型各自處理適合的工作
如果你正在評估公司適不適合導入開放權重模型、要不要自己架設,可以從導入診斷開始:我們會盤點你們的資料敏感度、用量與既有 IT 環境,建議適合的模型、使用方式與硬體規劃。
參考資料
- Artificial Analysis,〈LLM Leaderboard〉,2026 年 10 月 8 日查詢
- Artificial Analysis,〈Intelligence Benchmarking Methodology〉
- VentureBeat,〈Xiaomi's MiMo-V2.6-Pro debuts as the top open weights model in the world alongside cheaper V2.6-Flash〉,2026
- Qwen,〈Qwen3.8-2.4T-A95B 模型卡〉、〈授權全文〉,2026
- Artificial Analysis,〈Qwen3.8 2.4T A95B〉、〈Gemma 4 26B A4B〉
- LLM Stats,〈Qwen3.8-Max Open Weights: First Max-Class Qwen You Can Download〉,2026
- Z.ai,〈GLM-5.3 授權全文〉,2026
- Unsloth,〈GLM-5.3 部署指南〉
- Digital Applied,〈GLM-5.3's Weights Are Out. The Licence Is Not MIT〉,2026
- Moonshot AI,〈Kimi K3 模型卡〉、〈Kimi K3 License〉,2026
- TechNode,〈Moonshot AI to make Kimi K3 available for public download〉,2026
- AWS,〈Introducing Kimi K3 on Amazon Bedrock〉,2026
- DeepSeek,〈DeepSeek V4.1 Flash 發布公告〉、〈API 更新紀錄〉
- Mistral AI,〈Mistral Large 模型文件〉,2026
- Beam AI,〈Mistral Large 4: Benchmarks, Pricing and Open Weights〉,2026
- Wikipedia,〈Gemma (language model)〉
- OpenAI,〈Introducing gpt-oss〉,2025
- TAIDE,〈推動臺灣可信任生成式 AI 發展計畫〉、〈Gemma-3-TAIDE-12b-Chat-2602 模型卡〉
- 數位發展部資通安全署,〈公務機關全面禁用 DeepSeek AI 服務,未限制一般民間使用〉,2025
- 行政院公共工程委員會,〈工程企字第 1140100189 號函〉,2025
- Naseh 等,〈R1dacted: Investigating Local Censorship in DeepSeek’s R1 Language Model〉,arXiv,2025
- 中央社,〈DeepSeek 涉資安疑慮 數發部:公務機關不得使用〉,2025