前兩篇我們談了〈導入 RAG 知識庫前,先確認這 5 件事〉和〈2026 年企業 RAG 怎麼做〉。文章發出後,最常收到的回饋是:「可是我看到很多人說 RAG 已經死了,現在還值得做嗎?」
這個問題值得認真回答。「RAG 已死(RAG is dead)」不是少數人的酸言酸語:從技術部落客、創投觀點文章,到向量資料庫公司自己的訪談標題,2026 年都能看到這句話。
先說結論:
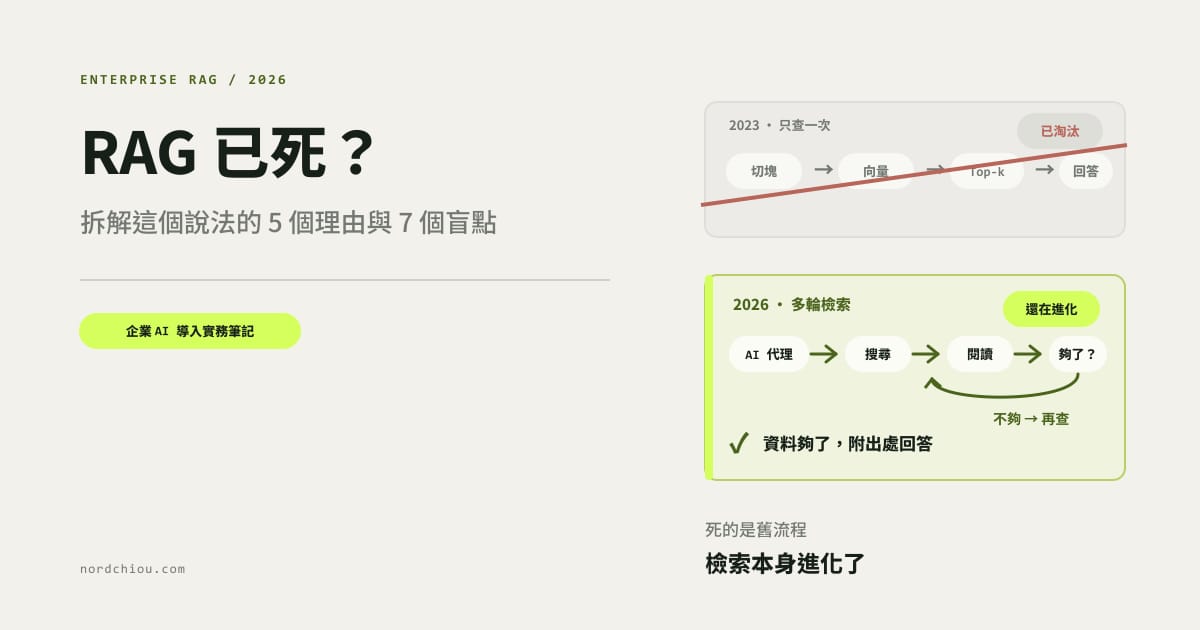
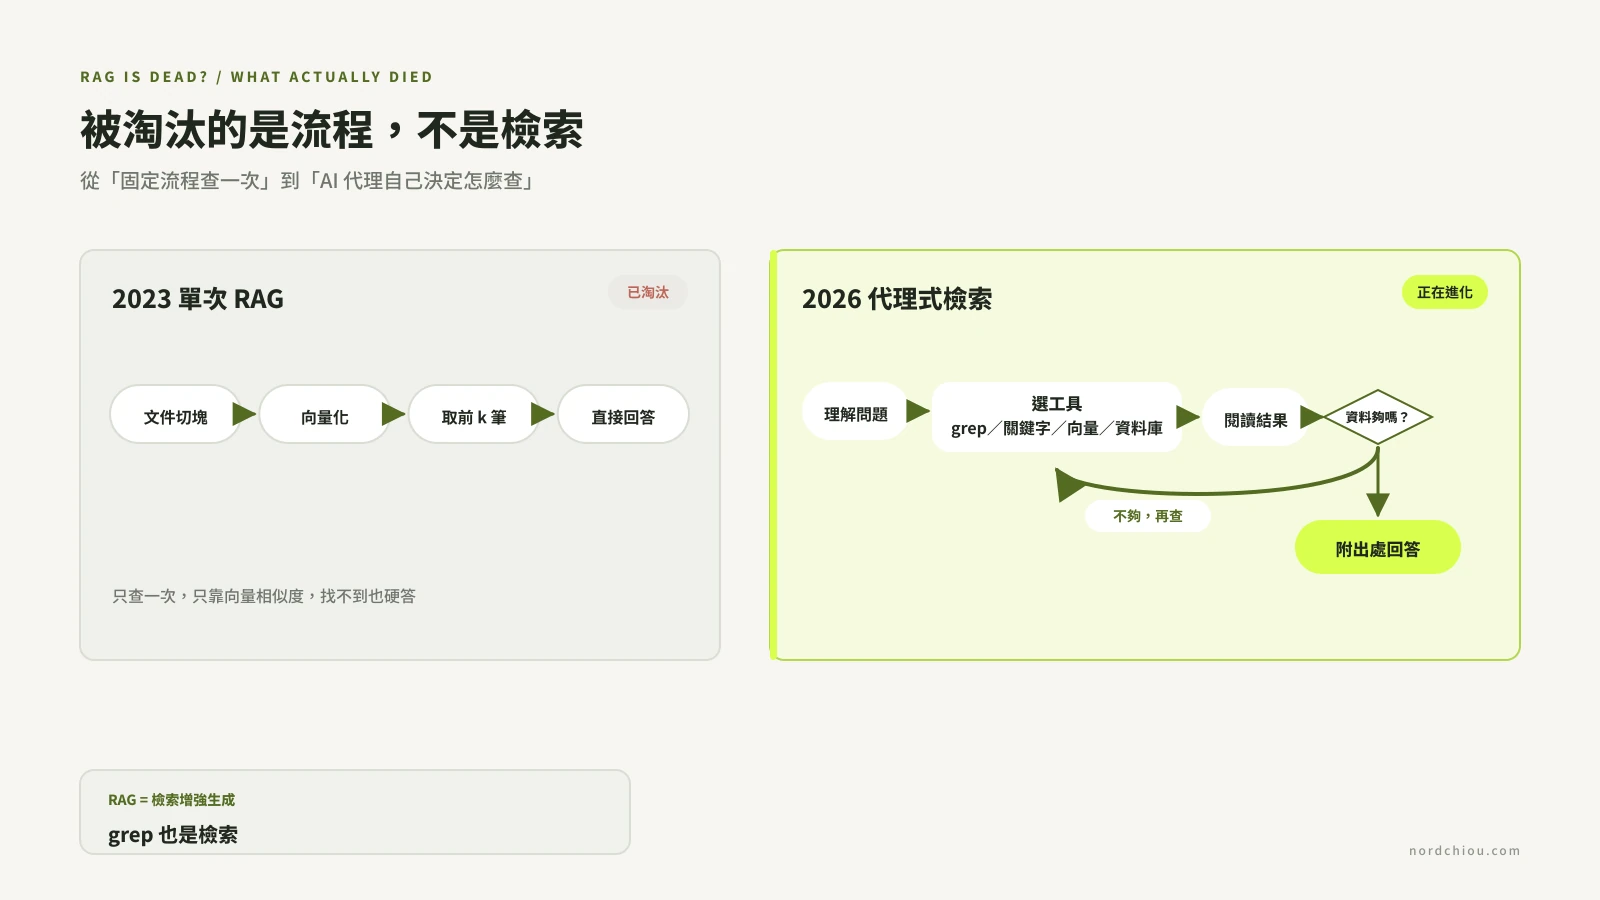
死掉的是 2023 年那種「切塊 → 向量化 → 取前幾筆 → 回答」的單次檢索流程,不是「先找資料、再回答」這件事。 對企業知識庫來說,檢索不但沒有消失,反而變得更講究。
以下先公平地整理「RAG 已死」這派的理由,再談他們套用到企業場景時容易忽略的地方。
「RAG 已死」這個說法從哪來?
這個說法不是一篇文章引起的,而是幾股趨勢在 2025–2026 年匯流:
- 技術社群:例如 AkitaOnRails 的〈Is RAG Dead? Long Context, Grep, and the End of the Mandatory Vector DB〉,主張大多數情況用長上下文加上 grep、BM25 這類字面搜尋就夠了,向量資料庫不再是必備。
- 產業預測:VentureBeat 的〈6 data predictions for 2026〉標題直接寫「RAG is dead」,認為在 AI Agent 的場景,「代理記憶(agentic memory)」的使用量會超過 RAG。
- 框架與工具廠商:LlamaIndex 發表〈RAG is dead, long live agentic retrieval〉;向量資料庫公司 Chroma 的創辦人上 Latent Space 的節目,集數標題是〈RAG is Dead, Context Engineering is King〉。
- 連發明者都出來回應:RAG 原始論文的共同作者 Douwe Kiela,在 2025 年寫了〈RAG is dead, long live RAG!〉為 RAG 辯護。
有趣的是,後面三篇的標題都是「XX 已死,XX 萬歲」的句型。這個句型本身就暗示了:被宣告死亡的,和活下來的,其實是同一件事的不同版本。
他們的 5 個理由
1. 上下文窗口大到可以直接放文件
2023 年主流模型的上下文窗口(context window)只有 4k 到 32k token,連一份完整的合約都放不下,不先篩選就根本無法回答。RAG 在當時是「不得不」的解法。
到了 2026 年,主流模型普遍支援數十萬到百萬 token,一整本產品手冊、甚至一整套規章都能直接放進提示。再加上提示快取(prompt caching)讓重複送出的內容大幅降價,「先檢索再回答」的必要性確實下降了。
2. 最強的 AI 寫程式工具,不用向量資料庫
這是「RAG 已死」派最常引用的證據。Anthropic 的 Claude Code 負責人 Boris Cherny 公開表示:
早期版本的 Claude Code 用的是 RAG 加上本機向量資料庫,但我們很快就發現,代理式搜尋(agentic search)通常效果更好。它也更簡單,而且沒有安全、隱私、資料過時與可靠度方面的問題。(原文)
所謂代理式搜尋,說穿了就是讓模型自己用 glob(找檔名)、grep(找字串)、讀檔案,一輪一輪地找,直到它認為資料足夠。沒有向量、沒有索引,卻打敗了精心設計的檢索流程。
3. 切塊與一次性檢索太脆弱
傳統 RAG 有兩個結構性問題:
- 切塊(chunking)很難切對:切太小會失去上下文,切太大又會混進無關內容。一張表格被切成兩半,答案就可能從此找不到。
- 只檢索一次:收到問題後檢索一次就定案。模型讀完資料發現「還缺另一份文件」,也沒有機會再查。
4. 建置與維護成本太高
一套完整的 RAG 要處理文件解析、切塊、向量化、索引更新、檢索調校、重新排序……每一段都是工程成本。AkitaOnRails 的文章估算,對許多中小型資料集而言,每次查詢多付一點 token 費用,可能比建置並長期維護一套檢索流程還划算。
5. 新名詞接手:情境工程、CAG、代理記憶
「RAG」這個詞本身也在退流行。取而代之的是:
- 情境工程(context engineering):重點不是「檢索」,而是「決定模型在每一步該看到什麼」。
- 快取增強生成(Cache-Augmented Generation,CAG):把整份知識預先載入並快取,查詢時完全不檢索。
- 代理記憶(agentic memory):讓 AI Agent 自己整理、更新、查詢長期記憶。
VONNG 的文章就指出:Douwe Kiela 雖然寫文章為 RAG 辯護,他的公司官網卻已經改用「情境工程」來描述自己。當一個名詞需要被「搶救」,本身就說明了它的處境。
他們說對了什麼
公平地說,上面五點大多是對的,特別是對「2023 年那一套」而言:
- 單一向量相似度,不該再是預設做法。 我們在〈2026 年企業 RAG 怎麼做〉裡也把「混合檢索」和「重新排序」列為基本配備,純向量搜尋漏掉料號、條號的問題早就被證實。
- 資料量小,就先別建 RAG。 同一篇文章的第 0 節就建議:幾百頁以內、不常更新的資料,先試長上下文加快取。
- 讓模型主導檢索,確實比固定流程強。 Agentic RAG 本來就是 2026 年的主流方向。
換句話說,「RAG 已死」派批評的對象,很多是業界自己也早就放棄的做法。問題出在,當這句話被簡化成「不需要檢索了」,並直接套用到企業知識庫時,就會漏掉很多事。
被忽略的 7 件事
1. grep 也是檢索:這是名詞之爭
RAG 的全名是 Retrieval-Augmented Generation,檢索增強生成。它從來沒有規定檢索一定要用向量。
Claude Code 用 grep 找到相關程式碼,再根據找到的內容寫程式,這個過程本身就是 RAG,只是檢索的工具從向量搜尋換成了字面搜尋,檢索的決策者從固定流程換成了模型。Hamel Husain 和 Ben Clavié 的系列文〈Stop Saying RAG Is Dead〉講得很直接:真正陣亡的是「單一向量搜尋」,不是檢索這門學問。
這不只是咬文嚼字。如果決策者聽到「RAG 已死」就以為「文件直接丟給 AI 就好」,後面幾點的問題都會在上線後才浮現。
2. 程式碼是特別適合 grep 的資料
Claude Code 的經驗非常有參考價值,但要注意它的資料是程式碼,而程式碼有幾個企業文件沒有的特性:
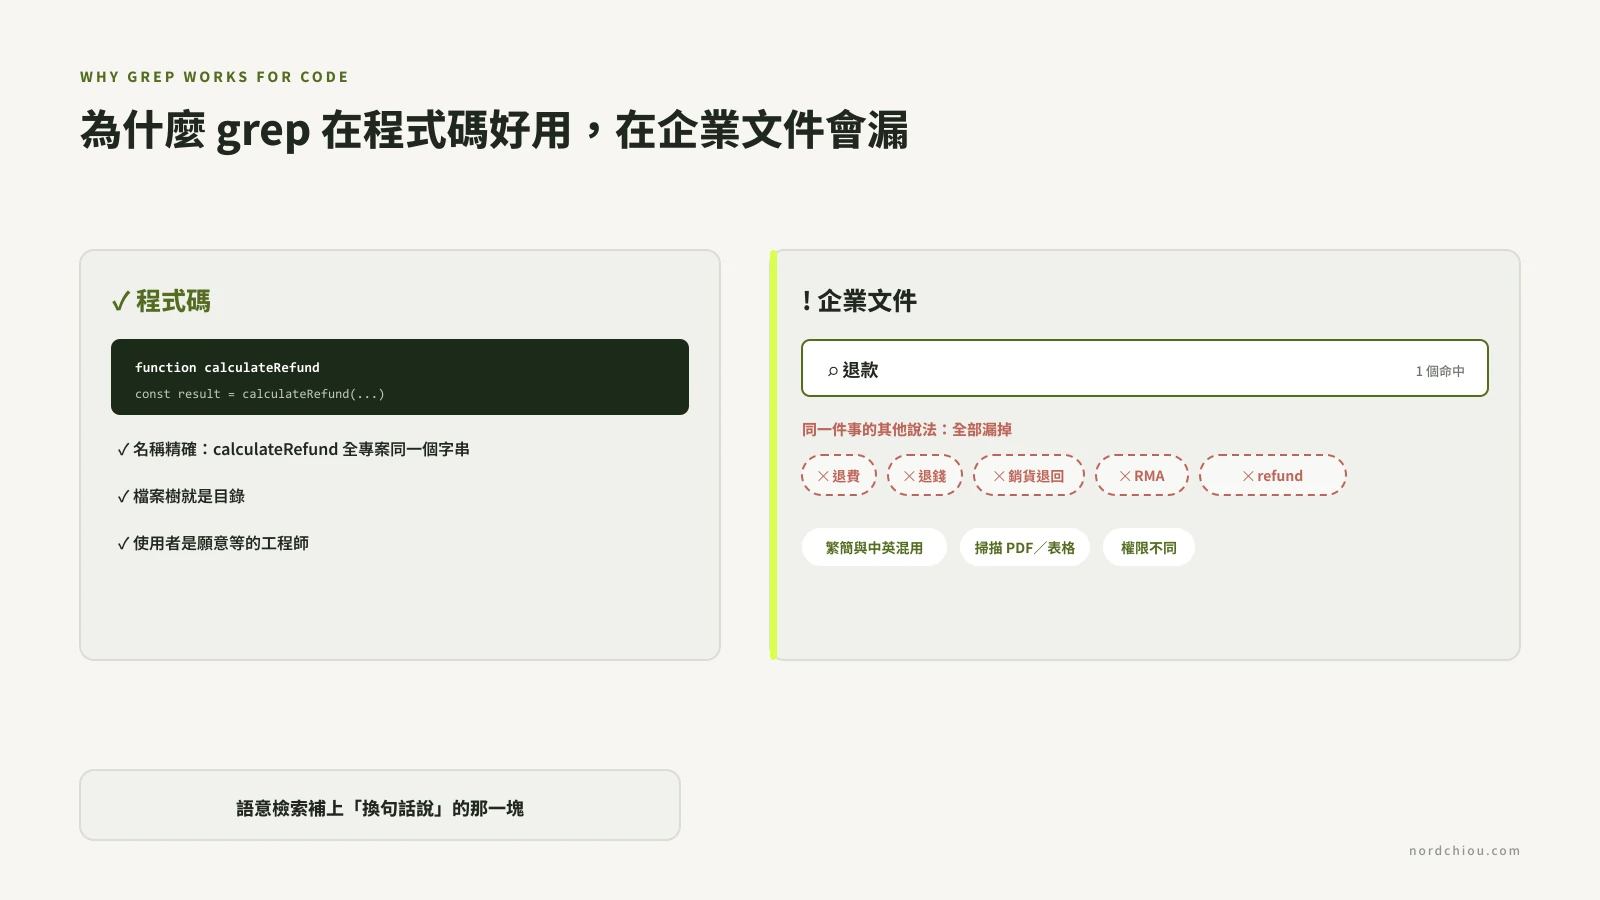
- 名稱是精確的:函式叫
calculateRefund,全專案都會用同一個字串呼叫它,grep 一定找得到。 - 結構就是索引:資料夾與檔名本身就是一份目錄,模型可以像工程師一樣「逛」過去。
- 使用者能等:工程師願意等 AI 花 30 秒搜尋十幾次,只要最後答案對。
企業文件剛好相反:客服紀錄寫「退錢」、作業規範寫「退款」、財務報表寫「銷貨退回」、系統欄位叫 RMA,同一件事有四五種說法。字面搜尋漏掉任何一種,模型就只看到部分資料,而且它通常不會知道自己漏了。
3. 中文讓這個問題更嚴重
英文圈的討論幾乎沒有提到語言差異,但對台灣企業來說這很關鍵:
- 用詞差異更多:繁簡混用(「軟體」與「软件」)、台灣與中國用語(「影片」與「視頻」)、中英夾雜(「PO 單」與「採購單」),都是字面搜尋的盲點。
- 斷詞影響關鍵字搜尋:grep 是比對子字串,不受斷詞影響;但 BM25 這類關鍵字搜尋需要先斷詞,中文若沒有搭配合適的斷詞器,效果會明顯打折。
- 模型猜不到內部黑話:代理式搜尋的優點是模型會自己換幾個同義詞再查,但它不可能知道你們公司把某個專案內部叫做「藍鯨案」。
這正是語意檢索(向量搜尋)仍然有價值的地方:它不是用來取代字面搜尋,而是補上「換句話說」的那一塊。
4. 上下文越長,模型不一定讀得越好
「窗口夠大,全部放進去就好」背後有一個假設:模型會平均、仔細地讀完所有內容。研究結果並不支持這個假設。
向量資料庫公司 Chroma 在 2025 年發表的〈Context Rot〉測試了 18 個主流模型,結論是:
- 所有模型的表現都會隨輸入變長而下降,即使離窗口上限還很遠。
- 問題和答案用詞越不相近,下降得越快。
- 內容中若有「看起來相關但其實不對」的干擾段落,錯誤會明顯增加。
更早的〈Lost in the Middle〉研究也發現,模型對開頭與結尾的內容比較敏感,放在中段的資訊容易被忽略。
企業文件恰好充滿「看起來相關但其實不對」的內容:舊版規章、草稿、已作廢的報價單。把它們全部塞進上下文,等於主動替模型製造干擾。 精挑細選過的少量段落,常常比一整疊資料更好用。
(附帶一提:這份研究出自向量資料庫公司,立場上自然偏向檢索,但它的測試方法與程式碼都已公開,可以自行驗證。)
5. 量一大,成本與速度會變成主角
「每次多花幾十元台幣,比建 RAG 便宜」在內部少量使用時成立,但量一放大就要重新算:
- 費用會乘上查詢量:假設每次查詢帶 20 萬 token,一天 1 萬次查詢,就是每天 20 億個輸入 token。就算快取打了很深的折扣,也很難比「每次只送幾千 token 的相關段落」便宜。
- 速度有物理限制:模型要先讀完輸入才能開始回答,輸入越長,第一個字出現的時間(TTFT)就越久。對客服、門市查詢這類要即時回應的場景,這很致命。
- 代理式搜尋也不便宜:它要跑好幾輪工具呼叫,每一輪都有延遲與費用,而且每次走的路徑可能不同,結果比較難重現,也比較難驗收。
程式碼助理的使用者是一位願意等的工程師;企業客服的使用者是一位不想等的客戶。場景不同,最佳解自然不同。
6. 權限控管:全部放進去,誰都看得到
這一點幾乎沒有出現在「RAG 已死」的討論裡,卻是企業導入時最常卡關的地方。
業務不該看到人事薪資、門市人員不該看到董事會紀錄、A 客戶不該查到 B 客戶的合約。檢索層天生就是做權限過濾的好位置:先依使用者身分篩出他能看的文件,再從中找答案。
如果做法是「把整個知識庫放進上下文」,權限就只能靠提示詞要求模型「不要說出來」,而這在資安上是站不住腳的。Boris Cherny 說代理式搜尋「沒有權限方面的問題」,是因為 Claude Code 在工程師自己的電腦上執行,本來就只讀得到他有權限的檔案。這個前提,在多人共用的企業知識庫裡並不成立。
7. 資料規模、更新頻率與出處
最後三個現實條件,放在一起談:
- 規模:100 萬 token 大約是幾千頁文件。企業累積十幾年的文件、郵件、工單,往往是這個量的數百、數千倍。Douwe Kiela 的說法是:即使有 1,000 萬 token 的窗口,你看到的仍然只是企業資料的一小部分。
- 更新:CAG 這類「預先載入整份知識」的做法,資料一變動就要重建快取。價目表、庫存、公告每天都在變的企業,檢索的即時性反而是優點。
- 出處與稽核:金融、醫療、法務等產業需要知道「這個回答根據哪份文件的第幾頁」。檢索流程天生會留下「找了什麼、用了什麼」的紀錄;把所有文件一次放進上下文,就很難說清楚模型實際根據的是哪一段。
那企業到底該怎麼選?
與其問「RAG 死了沒」,不如問「我的資料和使用情境,需要多聰明的檢索?」
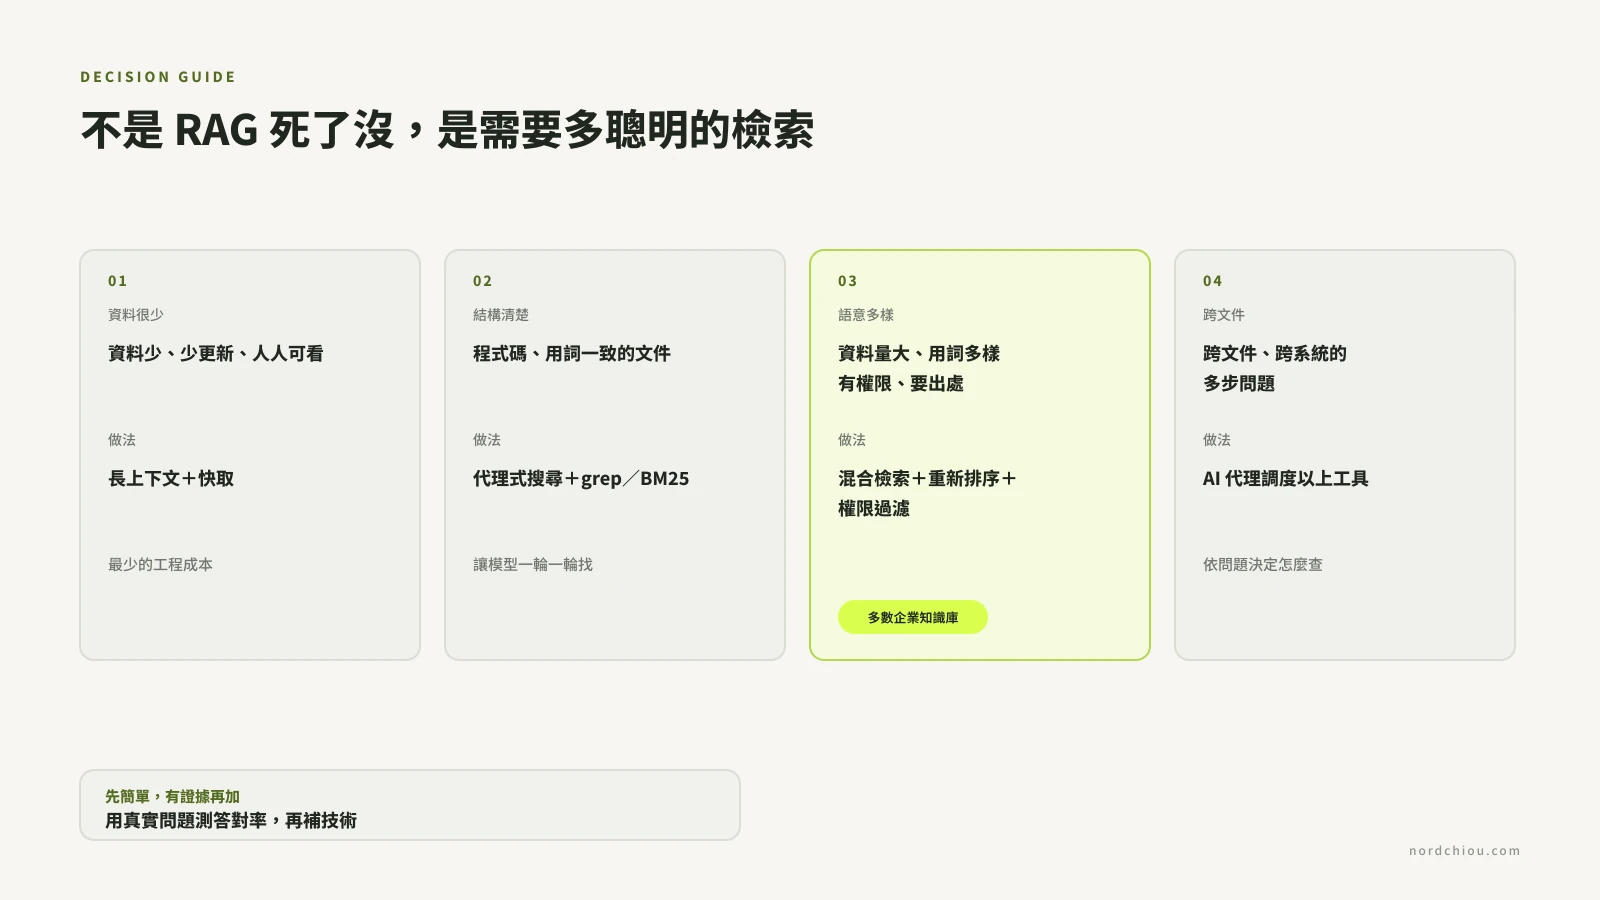
| 你的情況 | 建議做法 |
|---|---|
| 資料量小(幾百頁內)、很少更新、所有人都能看 | 長上下文+提示快取,先不建檢索 |
| 程式碼,或結構清楚、用詞一致的技術文件 | 代理式搜尋+字面搜尋(grep、BM25) |
| 資料量大、用詞多樣、中英混雜 | 混合檢索(關鍵字+語意)+重新排序 |
| 不同部門、不同客戶能看的資料不同 | 檢索時先依權限過濾,不要全部放進上下文 |
| 需要附出處、可稽核 | 保留檢索紀錄,回答附文件名與頁碼 |
| 問題需要跨文件、跨系統多步查詢 | 由 AI 代理調度上述檢索工具(Agentic RAG) |
實務上,我們的做法是「先簡單,有證據再加」:
- 先用少量真實問題測試長上下文或字面搜尋,看答對率。
- 找出答錯的題目,判斷是「沒找到」、「找錯」還是「找到了但讀錯」。
- 針對問題補上對應技術:用詞多樣就加語意檢索,候選太多就加重新排序,權限複雜就在檢索層處理。
AkitaOnRails 的建議其實也是這個方向:從便宜的字面篩選開始,等真實資料證明它不夠用,再加向量。這點「RAG 已死」派和「RAG 沒死」派並沒有衝突。
結語:與其說死了,不如說長大了
回頭看,「RAG 已死」的爭論裡,雙方其實同意大部分的事:
- 2023 年那種單次向量檢索,已經不夠用。
- 上下文變大、模型變聰明,讓「怎麼檢索」有了更多選擇。
- 讓模型主導、多輪查詢的做法,會越來越普遍。
真正的差異在於:把一個在程式碼、單人使用情境成功的做法,直接推廣到所有場景。 企業知識庫要面對的是多種用詞、大量舊資料、權限區分、稽核要求與成千上萬的使用者,這些都讓「找對資料」這件事比以往更重要,而不是更不重要。
最後提醒一點:讀這類文章時,可以留意作者的立場。賣長上下文模型的公司,自然樂見「不需要檢索」;賣向量資料庫的公司,自然強調「檢索不可或缺」。最可靠的判斷依據,永遠是用你自己的資料和問題實際測一輪。
如果你正在評估公司的知識庫該用哪一種做法,歡迎從導入診斷開始:我們會抽樣你的文件與常見問題,實際測試長上下文、字面搜尋與混合檢索的差異,再決定哪些技術值得投入。
參考資料
- AkitaOnRails,〈Is RAG Dead? Long Context, Grep, and the End of the Mandatory Vector DB〉,2026
- VentureBeat,〈6 data predictions for 2026: RAG is dead, what's old is new again and the future of vector databases〉
- LlamaIndex,〈RAG is dead, long live agentic retrieval〉
- Latent Space,〈RAG is Dead, Context Engineering is King — with Jeff Huber of Chroma〉
- Douwe Kiela,〈RAG is dead, long live RAG!〉,Contextual AI,2025
- VONNG,〈RAG Isn't Dead. But It's Getting There.〉
- Boris Cherny,關於 Claude Code 改用代理式搜尋的說明,X
- Hamel Husain、Ben Clavié,〈Stop Saying RAG Is Dead〉
- Chroma,〈Context Rot: How Increasing Input Tokens Impacts LLM Performance〉,2025
- Liu et al.,〈Lost in the Middle: How Language Models Use Long Contexts〉,2023