上一篇〈導入 RAG 知識庫前,先確認這 5 件事〉談的是導入前的準備。這篇接著談技術:當知識庫已經在規劃,怎麼讓 AI 真的找得到對的資料、答得出可以查核的答案。
先說結論:RAG 系統答錯,多數時候不是模型不夠聰明,而是一開始就沒找到對的段落。以下 6 個技術,幾乎都在解決「找資料」這一步。
0. 先問一句:這個案子真的需要 RAG 嗎?
2026 年的主流模型,上下文長度已經普遍達到數十萬到上百萬 token。如果你的資料量不大,直接把整份資料放進提示裡,往往比建一套檢索系統更簡單、也更準。
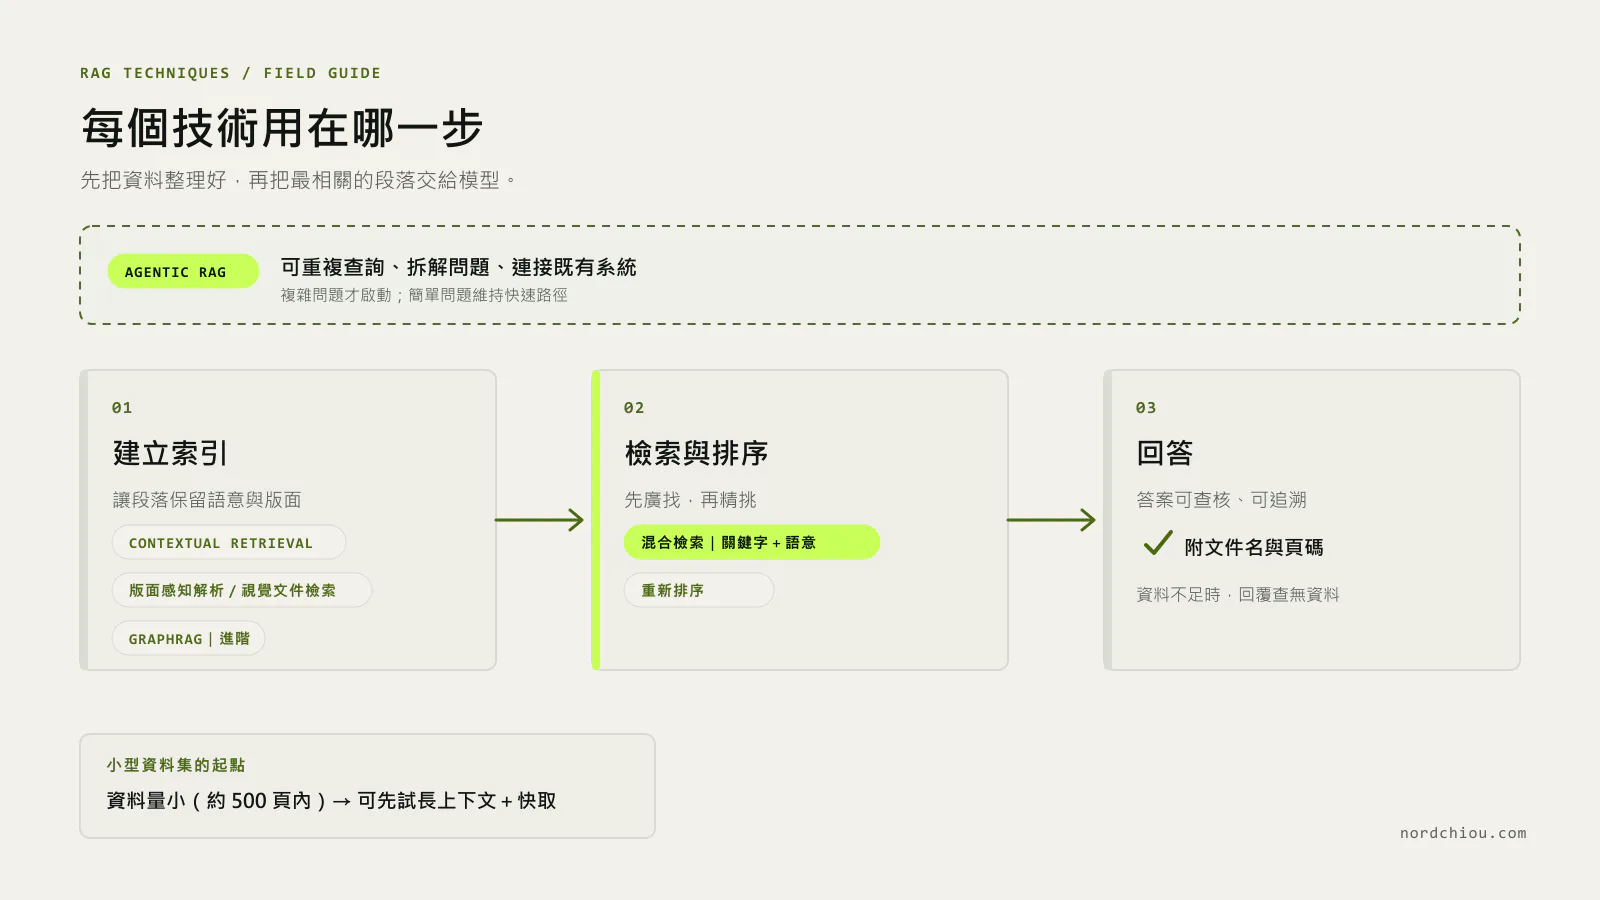
Anthropic 在 2024 年的建議是:知識庫小於約 20 萬 token(大約 500 頁)時,可以直接整份放進提示,再搭配提示快取(prompt caching)降低重複送出的成本與延遲。
但以下情況,RAG 仍然是比較好的選擇:
- 資料量大:文件多到放不進單次請求,或每次都送全部會太慢、太貴。
- 資料常更新:RAG 只要更新有變動的文件索引,不必每次重送全部內容。
- 需要出處與稽核:要清楚知道每個回答引用了哪一份文件、哪一頁。
- 權限不同:不同部門能查的文件不一樣,必須先依權限篩選再回答。
小型、固定的資料集(例如一份產品手冊)先試「長上下文+快取」;資料量大、會更新、有權限區分的企業知識庫,才需要完整的 RAG。
1. 混合檢索:關鍵字與語意一起找
早期的 RAG 多半只用向量搜尋(依語意相似度找段落)。它擅長理解「換句話說」的問題,卻常漏掉需要精確比對的內容,例如:
- 料號、型號:
A-3021-B - 法規條號、合約條款:「第 5 條」
- 人名、客戶名、專有名詞
混合檢索(hybrid search) 同時跑傳統關鍵字搜尋(例如 BM25)與向量搜尋,再把兩邊的結果合併排序。這幾乎是現在企業 RAG 的標準配備,對料號、規格這類中小企業最常查的內容特別有感。
2. 重新排序(Rerank):先粗找,再精挑
檢索通常會先撈出幾十個候選段落,但真正相關的可能只有前幾個。重新排序模型(reranker) 會把「問題」和「每個候選段落」放在一起逐一評分,把最相關的排到最前面,再交給模型回答。
它比第一輪檢索慢,所以只用在已經篩過的少量候選上。實務上,加一層 rerank 往往是投入最少、效果最明顯的改善之一。
3. Contextual Retrieval:讓每個段落「知道自己在講什麼」
文件切成小段後,很多段落會失去上下文。例如一段寫著「本季營收成長 3%」,單獨看根本不知道是哪家公司、哪一季。
Contextual Retrieval 的做法是:建立索引前,先讓模型為每個段落補上一小段說明(例如「這段出自 A 公司 2026 年第二季財報的營收章節」),再拿補充後的內容去建立向量索引與關鍵字索引。
Anthropic 在提出這個方法時公布的測試結果(以前 20 個檢索結果中是否找到正確段落為準):
| 做法 | 檢索失敗率降低 |
|---|---|
| 只用補充說明後的向量索引 | 35% |
| 補充說明+關鍵字(BM25)混合檢索 | 49% |
| 再加上重新排序 | 67% |
這組數字來自 Anthropic 的測試資料集,實際效果會因你的文件而不同;但它清楚說明了一件事:前面三個技術可以疊加使用,效果會一路累積。
4. 視覺文件檢索:掃描檔、表格與圖表也能查
台灣企業的文件,有很大一部分是掃描 PDF、Excel 轉出來的表格、夾帶圖表的簡報。傳統做法是先做文字辨識(OCR)再切段落,但表格結構、圖表內容常在這一步就遺失了。
兩個方向可以改善:
- 版面感知的文件解析:保留標題層級、表格欄位與頁碼,而不是把整頁壓成一串文字。
- 視覺文件檢索:以 ColPali 為代表,直接把「頁面圖片」拿來建立索引與比對,跳過容易出錯的文字辨識;它延續了 ColBERT 的 late interaction 檢索方式。這類方法近兩年發展很快,特別適合版面複雜的規格書、型錄與報表。
導入前可以先抽 20 份最常被查的文件,看看它們是不是以掃描檔或表格為主,再決定要不要投資這一塊。
5. Agentic RAG:讓 AI 自己決定要查什麼、查幾次
傳統 RAG 是固定流程:收到問題 → 檢索一次 → 回答。遇到需要多步推理的問題就容易卡住,例如:
「上個月延遲出貨的訂單,有哪些客戶的合約有違約金條款?」
這需要先查出貨紀錄、找出延遲的訂單與客戶,再逐一查合約。Agentic RAG 讓模型像人一樣工作:
- 自己改寫問題、拆成多個子問題,分次檢索。
- 判斷資料夠不夠,不夠就換關鍵字再查,而不是硬答。
- 透過工具查即時系統:例如用 MCP(Model Context Protocol) 這類標準介面連接 ERP、資料庫,而不只查靜態文件。
代價是每個問題會花比較多的時間與模型費用,所以適合用在高價值、多步驟的查詢,而不是每一個簡單問題。這也是我們在 AI Agent 專案中最常搭配的做法:簡單問題走快速檢索,複雜問題再交給 Agent。
6. GraphRAG:適合「關係」型問題,但先別急著上
一般 RAG 找的是「最相關的段落」。但有些問題的答案不在任何一段文字裡,而在資料之間的關係,例如:
- 「哪些規章引用了這條已經廢止的規定?」
- 「這個零件的供應商,還供貨給我們哪些產品線?」
GraphRAG 會先把文件裡的人、事、物與它們的關係整理成知識圖譜,再依圖譜回答,微軟的 GraphRAG 是代表性的開源實作。它擅長跨文件彙整與關係推理,但建立與維護圖譜的成本明顯高於一般 RAG,也需要依產業調整。
我們的建議是:先把前面幾項做好,確認真的有大量「關係型」問題答不好,再評估要不要導入 GraphRAG。
怎麼挑:依情況建議的組合
| 你的情況 | 建議先做 |
|---|---|
| 資料不多(幾百頁內)、很少更新 | 長上下文+提示快取,先不建 RAG |
| 常查料號、規格、條號 | 混合檢索+重新排序 |
| 文件切段後常「答非所問」 | Contextual Retrieval |
| 掃描 PDF、表格、型錄很多 | 版面感知解析或視覺文件檢索 |
| 問題需要跨文件、跨系統多步查詢 | Agentic RAG,搭配工具連接既有系統 |
| 大量「誰和誰有關」的問題 | 評估 GraphRAG |
不論用哪一種,都別忘了上一篇提到的兩件事:回答要附出處,以及用測試題庫驗證每一次調整是否真的變好。技術選對了,還是要用數據確認。
如果你不確定自己的資料適合哪一種做法,可以從導入診斷開始:我們會抽樣你的文件與常見問題,實際評估哪些技術值得投入。
參考資料
- Anthropic,〈Introducing Contextual Retrieval〉,2024
- Faysse et al.,〈ColPali: Efficient Document Retrieval with Vision Language Models〉,2024
- Khattab & Zaharia,〈ColBERT: Efficient and Effective Passage Search via Contextualized Late Interaction over BERT〉,2020
- Microsoft,GraphRAG
- Model Context Protocol